En bref
- La surveillance en temps réel collecte et analyse en continu les données opérationnelles pour permettre des informations immédiates sur les performances des actifs. Elle utilise des agents légers, des processeurs de flux et des outils de visualisation pour détecter rapidement les anomalies, réduisant ainsi les temps d'arrêt et améliorant la précision de la maintenance. Le succès dépend d'une architecture appropriée, de flux de travail intégrés et d'une discipline opérationnelle pour des résultats optimaux.
La surveillance en temps réel est définie comme la collecte et l'analyse automatisées et continues de données opérationnelles avec une latence minimale, offrant une visibilité immédiate sur les performances des actifs et la santé du système. Contrairement aux contrôles planifiés traditionnels, elle traite les données de télémétrie, y compris les métriques, les journaux, les traces et les événements, au fur et à mesure qu'ils se produisent, permettant aux professionnels de la maintenance et aux responsables des opérations de détecter les anomalies avant qu'elles ne s'aggravent. Des outils tels que Prometheus, Grafana et PagerDuty se trouvent au centre de la plupart des mises en œuvre modernes, tandis que les technologies au niveau du noyau comme eBPF ont rendu la collecte de données beaucoup moins gourmande en ressources que les anciennes méthodes d'interrogation.
Qu'est-ce que la surveillance en temps réel et comment fonctionne-t-elle dans les environnements opérationnels ?
La surveillance en temps réel fonctionne en déployant des agents ou des collecteurs légers directement sur les actifs, les serveurs ou les équipements industriels pour collecter des données de télémétrie en continu. Ces agents transmettent les données à une couche de traitement, où des processeurs de flux et des bases de données de séries temporelles les analysent en quelques secondes. Les objectifs de latence vont de moins d'une seconde à 60 secondes, une amélioration spectaculaire par rapport aux intervalles d'interrogation de 5 à 15 minutes typiques de la surveillance traditionnelle. Pour les équipes d'exploitation gérant des dizaines de machines ou d'équipements de terrain, cette différence détermine si une panne est détectée tôt ou se transforme en une panne coûteuse.
L'architecture technique qui sous-tend un suivi efficace des données en temps réel suit un modèle bien établi :
- Agents et collectionneurs déployer sur les actifs surveillés pour capturer l'utilisation du processeur, la température, la pression, les taux d'erreur et d'autres métriques opérationnelles
- Outils au niveau du noyau comme eBPF exécute des programmes en bac à sable directement dans le noyau du système d'exploitation, offrant une visibilité approfondie avec une surcharge CPU presque nulle
- Files de messages tel que le tampon Apache Kafka et l'acheminement de flux de données à haut volume vers des processeurs en aval
- Processeurs de flux tels qu'Apache Flink et Apache Storm appliquent des règles de filtrage, d'agrégation et de détection d'anomalies en flux continu
- Bases de données temporelles comme InfluxDB et TimescaleDB stockent les données traitées pour les requêtes et l'analyse des tendances
- Tableaux de bord comme Grafana visualise les données en direct, tandis que les intégrations d'alertes avec des plateformes telles que PagerDuty déclenchent automatiquement des flux de travail d'incidents
Conseil de pro : Lors de la configuration des intervalles de collecte, la collecte de données toutes les 10 secondes est une référence largement utilisée. Aller beaucoup plus vite sans agrégation en périphérie peut épuiser les ressources de l'agent et dégrader les performances des actifs mêmes que vous surveillez.
La logique d'alerte fonctionne sur deux niveaux. Les seuils statiques se déclenchent lorsqu'une métrique franchit une limite fixe, telle qu'une température de moteur dépassant 85 °C. La détection dynamique des anomalies apprend le comportement de référence au fil du temps et signale les écarts même lorsque les seuils absolus ne sont pas franchis. Les deux approches sont nécessaires pour un suivi performant en temps réel dans les environnements industriels.
Quels sont les avantages de la surveillance en temps réel pour la gestion des actifs ?
La justification opérationnelle de la surveillance en temps réel repos sur quatre résultats mesurables : une détection plus rapide, une résolution plus rapide, une réduction des coûts d'indisponibilité et une plus grande précision de la maintenance.
- Temps moyen de détection (MTTD) et temps moyen de résolution (MTTR) réduits. Capturer les anomalies au fur et à mesure qu'elles se produisent permet aux équipes d'intervention sur incident d'agir en quelques minutes plutôt qu'en heures, évitant ainsi que des pannes mineures ne se transforment en interruptions de production en cascade.
- Précision de la maintenance prédictive. Implémentations avancées augmentez la précision de la maintenance prédictive de 45% en corrélationnant des données de capteurs en temps réel avec des schémas de pannes historiques. Pour les professionnels de la maintenance gérant des systèmes CVC, des machines industrielles ou des flottes automobiles, cela réduit directement les coûts de remplacement imprévus.
- Consolidation des infrastructures. Les plates-formes qui unissent les données de séries temporelles, de graphes, de documents et de vecteurs au sein d'un même moteur, telles qu'ArcadeDB, consolident plusieurs types de données et réduisent le nombre d'outils distincts qu'une équipe doit gérer.
- Coût total de possession inférieur. Les moteurs d'ingestion de flux à haute performance délivrent jusqu'à 60% de CPT en moins par rapport aux pipelines ETL par lots hérités, avec une diffusion des informations jusqu'à 10 fois plus rapide.
- Amélioration continue. Des flux de données opérationnelles en temps réel alimentent directement les cycles de réduction des déchets et d'optimisation des processus, fournissant aux responsables des opérations la base factuelle nécessaire pour justifier des modifications de calendriers de maintenance ou des décisions d'investissement en capital.
“Le passage à la surveillance en temps réel est motivé par la nécessité de minimiser les temps d'arrêt grâce à une détection et une résolution plus rapides des incidents. Il ne s'agit pas d'une préférence technologique. C'est une exigence de continuité d'activité pour toute organisation où les temps d'arrêt imprévus entraînent un coût financier direct.
Pour les équipes de maintenance gérant gestion du cycle de vie des actifs sur plusieurs sites, l'importance de la surveillance en temps réel va au-delà de la simple détection des pannes individuelles. Elle crée une boucle de rétroaction continue entre les conditions sur le terrain et les décisions de gestion.
Comment la surveillance en temps réel se compare-t-elle à la surveillance traditionnelle ?
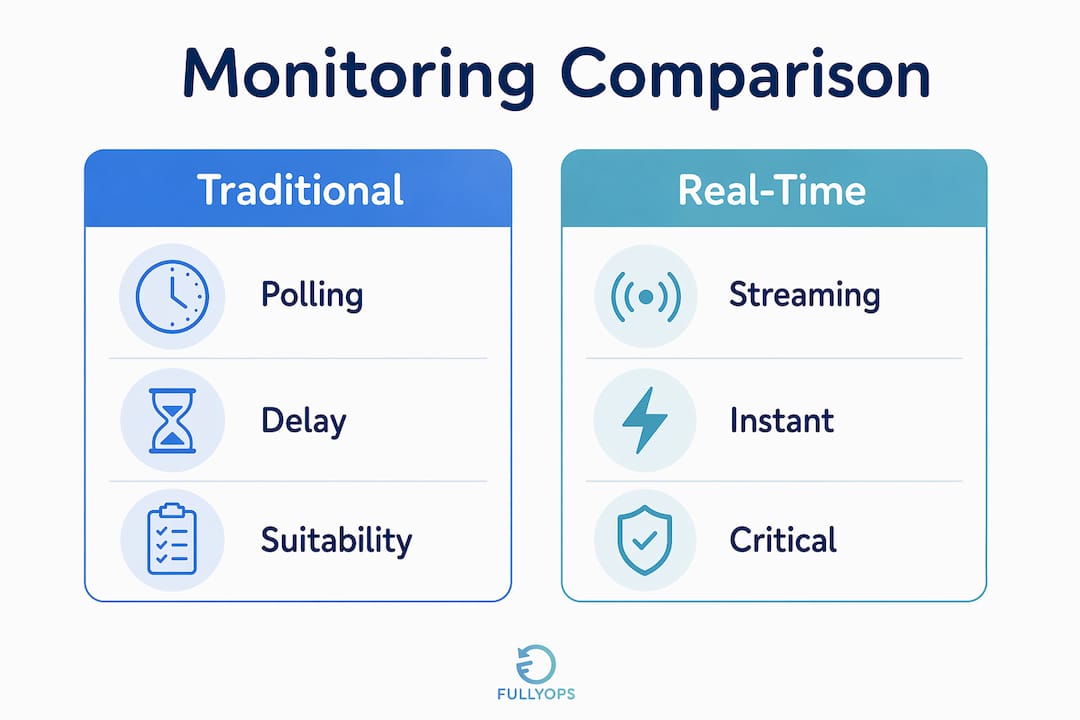
Comprendre la différence entre les deux approches aide les responsables des opérations à prendre la bonne décision d'investissement pour leur environnement.
| Caractéristique | Surveillance traditionnelle | Contrôle en temps réel |
|---|---|---|
| Intervalle d'interrogation | 5 à 15 minutes | De moins d'une seconde à 60 secondes |
| Retard d'alerte | Minutes en heures | Secondes en minutes |
| Fraîcheur des données | Obsolète par conception | Actuel par conception |
| Demande de stockage | Inférieur | Plus haut sans filtrage des bords |
| Coût de calcul | Inférieur | Modéré à élevé |
| Convient le mieux à | Actifs stables à faible criticité | Actifs à haute valeur, dynamiques ou critiques pour la sécurité |
| Coût total de possession au fil du temps | Plus élevé en raison des coûts liés aux incidents | Moins élevé avec une architecture appropriée |
La surveillance traditionnelle convient aux environnements où les actifs changent lentement et où de brefs retards dans la détection des pannes comportent de faibles risques. Le suivi des données en temps réel est le bon choix lorsque la défaillance d'un actif entraîne des conséquences financières, de sécurité ou de réputation importantes. Une chaîne de fabrication, une unité de réfrigération dans un centre de distribution alimentaire ou une pompe de terrain dans une station de traitement des eaux entrent toutes dans cette dernière catégorie.
Conseil de pro : Ne remplacez pas la surveillance traditionnelle en bloc. Utilisez la surveillance en temps réel pour les actifs critiques et les modes de défaillance à haute fréquence, et conservez les contrôles planifiés pour l'infrastructure à faible risque et à faible taux de changement. L'approche hybride maîtrise les coûts tout en maintenant la couverture.
L'argument du TCO en faveur des systèmes en temps réel se renforce avec le temps. Le coût initial de l'infrastructure de streaming est compensé par la réduction des coûts de réparation d'urgence, des pertes de production et des heures de travail consacrées à l'investigation d'incidents qui auraient pu être évités.
Quels sont les outils et les étapes nécessaires pour mettre en œuvre une surveillance en temps réel ?
Une mise en œuvre efficace suit une séquence structurée plutôt qu'une approche privilégiant la technologie. Les équipes opérationnelles qui sélectionnent des outils avant de définir leurs besoins en données surdimensionnent systématiquement leur infrastructure et obtiennent des résultats insuffisants en matière de qualité des alertes.
Les étapes de mise en œuvre principales sont :
- Définir ce qu'il faut surveiller. Identifiez les actifs, les mesures et les modes de défaillance qui présentent le risque opérationnel le plus élevé. La température, les vibrations, la pression, les taux d'erreur et le débit sont des points de départ courants pour les environnements industriels.
- Sélectionnez les agents appropriés. Choisissez des agents qui correspondent à votre type d'actif. Pour l'infrastructure informatique, des outils comme les exportateurs Prometheus ou les collecteurs basés sur eBPF conviennent bien. Pour les équipements industriels, des connecteurs OPC-UA ou des agents IoT dédiés sont plus appropriés.
- Choisissez une architecture de streaming. Systèmes de surveillance en temps réel comprennent généralement Kafka pour la mise en file d'attente des messages, Flink ou Storm pour le traitement des flux, et InfluxDB ou TimescaleDB pour le stockage des séries temporelles. Sélectionnez des composants que votre équipe peut exploiter et maintenir.
- Créer des tableaux de bord dans Grafana. Grafana se connecte nativement à la plupart des bases de données de séries temporelles et fournit la couche de visualisation en direct que les équipes de maintenance utilisent lors des passations de service et de la gestion des incidents.
- Établir des règles d'alerte. Configurez à la fois des seuils statiques et une détection d'anomalies dynamique. Acheminez les alertes vers PagerDuty ou des plateformes de gestion des incidents équivalentes pour déclencher automatiquement la création d'ordres de travail.
- Appliquer l'agrégation de bords. Équilibrer les intervalles de collecte des données et le pré-filtrage des données en périphérie réduit les coûts de stockage et évite la fatigue liée aux alertes sans sacrifier la précision de la détection.
Pour les équipes qui gèrent efficacité du service sur le terrain, l'intégration d'alertes en temps réel directement dans les flux de travail de gestion des bons de travail est l'étape qui convertit les données de surveillance en actions de maintenance. Sans cette intégration, les alertes restent de simples notifications plutôt que des déclencheurs de résolution.
Quels défis les entreprises doivent-elles prendre en compte avec la surveillance en temps réel ?
La surveillance en temps réel n'est pas une solution complète en soi, et plusieurs idées fausses courantes amènent les organisations à la mettre en œuvre de manière inadéquate.
La plus grande idée reçue est que la surveillance en temps réel remplace l'analyse des causes profondes. La surveillance est l'alarme incendie ; l'observabilité est l'enquêteur qui explique pourquoi un incident s'est produit. Des outils comme Grafana et PagerDuty vous disent que quelque chose ne va pas et quand cela a commencé. Les plateformes d'observabilité qui corrèlent les traces, les journaux et les métriques vous disent pourquoi. Les deux sont nécessaires pour une gestion mature des incidents.
Autres défis à relever avant le déploiement :
- Fatigue d'alarme. Sans un filtrage intelligent et des seuils bien ajustés, la surveillance à haute fréquence génère un bruit qui désensibilise les équipes face aux véritables alertes. L'agrégation en périphérie (edge) et l'ajustement de la détection d'anomalies constituent les principales mesures d'atténuation.
- Compromise des méthodes d'ingestion de données. L'ingestion par poussée, où les agents envoient des données vers un collecteur central, passe mieux à l'échelle pour les grands parcs de ressources. L'ingestion par tirage, où le collecteur demande des données aux agents, est plus simple à configurer mais crée des goulets d'étranglement à grande échelle.
- Intégration avec les flux de travail des incidents. Les données de surveillance ne créent de valeur que lorsqu'elles déclenchent une réponse définie. Relier les alertes à processus de gestion des ordres de travail ferme la boucle entre la détection et la résolution.
- Coût du stockage à grande échelle. Les données à haute fréquence provenant de centaines d'actifs s'accumulent rapidement. Les politiques de rétention, le sous-échantillonnage des données et le stockage hiérarchisé sont des pratiques courantes pour maîtriser les coûts sans perdre la visibilité historique.
Principaux enseignements
La surveillance en temps réel n'apporte un avantage opérationnel mesurable que lorsque son architecture, sa logique d'alerte et ses flux de travail en cas d'incident sont conçus conjointement plutôt que de manière isolée.
| Point | Détails |
|---|---|
| La latence est la différence déterminante | La surveillance en temps réel vise des mises à jour inférieures à la seconde ou allant jusqu'à 60 secondes, contre 5 à 15 minutes pour l'interrogation traditionnelle. |
| La précision de la maintenance prédictive s'améliore | Les mises en œuvre avancées augmentent la précision de la maintenance prédictive de 45%, réduisant ainsi les pannes imprévues. |
| La surveillance et l'observabilité sont distinctes | La surveillance signale les problèmes ; les outils d'observabilité en étudient la cause racine. Les deux sont nécessaires. |
| L'architecture importe avant les outils | Définissez les actifs critiques et les modes de défaillance avant de sélectionner Kafka, Flink, InfluxDB ou Grafana. |
| L'intégration favorise la résolution | Relier les alertes aux flux de travail des bons de travail transforme les données de surveillance en actions de maintenance. |
Pourquoi la surveillance en temps réel ne vaut que par l'équipe qui la gère
En travaillant en étroite collaboration avec les équipes d'exploitation et de maintenance dans les environnements industriels, le schéma que j'observe le plus souvent est celui-ci : les organisations investissent dans la pile technologique et n'investissent pas assez dans les processus opérationnels qui la rendent utile. Un tableau de bord Grafana affichant des données d'actifs en temps réel a une réelle valeur. Un tableau de bord Grafana dont les alertes sont acheminées vers une boîte de réception que personne ne consulte pendant les équipes de nuit n'en a pas.
Les équipes qui tirent le plus de valeur du suivi des performances en temps réel sont celles qui le considèrent comme une discipline opérationnelle, et non comme un déploiement de logiciel. Elles définissent des procédures d'escalade avant le lancement. Elles ré Révisent les seuils d'alerte chaque trimestre. Elles connectent les résultats de la surveillance directement à programmes de maintenance prédictive afin que les données guident l'action plutôt que de rester stockées dans une base de données.
La prochaine frontière est la détection d'anomalies pilotée par l'IA, où les modèles entraînés sur des données historiques spécifiques aux actifs remplacent entièrement les seuils statiques. Plusieurs plateformes de surveillance industrielle évoluent déjà dans cette direction, et les améliorations de précision sont significatives. Cela étant dit, la détection pilotée par l'IA nécessite toujours le même travail fondamental : des données propres, des actifs bien définis et des flux de travail d'incidents intégrés. La technologie ne se substitue pas à la rigueur opérationnelle.
Mon conseil honnête est de commencer par trois à cinq actifs critiques, de mettre en place d'abord le flux de travail complet, de la détection à la résolution, pour ces actifs, puis d'étendre. Les organisations qui essaient de tout surveiller dès le premier jour finissent généralement par ne rien surveiller efficacement.
— Pedro
Comment Fullyops prend en charge la surveillance des actifs en temps réel dans la pratique
Fullyops est conçu pour les responsables des opérations et les professionnels de la maintenance qui ont besoin de plus qu'un simple tableau de bord de surveillance. La plateforme connecte les données d'actifs en temps réel à gestion des ordres de travail, l'allocation des ressources et les rapports opérationnels dans un environnement unique. Lorsqu'une alerte se déclenche, Fullyops peut déclencher un ordre de travail, affecter le bon technicien et consigner l'intervention automatiquement, comblant ainsi l'écart entre la détection et la résolution que la plupart des outils de surveillance seuls laissent ouvert. Pour les équipes qui cherchent à aligner leur investissement en matière de surveillance sur une approche structurée de gestion des actifs, le guide des systèmes de gestion d'actifs sur Fullyops est un point de départ pratique. Vous pouvez également explorer le tutoriel sur l'allocation des ressources pour voir comment les données opérationnelles en temps réel se traduisent par une meilleure planification de la maintenance.
FAQ
En termes simples, la surveillance en temps réel est le suivi d'événements ou de données au moment même où ils se produisent.
La surveillance en temps réel est l'observation automatisée et continue des données de performance d'un actif ou d'un système avec un délai minimal, se mettant généralement à jour toutes les secondes ou toutes les 60 secondes. Elle permet aux équipes d'exploitation de détecter les pannes et les anomalies dès qu'elles se produisent plutôt que de les découvrir lors de contrôles planifiés.
En quoi la surveillance en temps réel diffère-t-elle de la surveillance traditionnelle ?
La surveillance traditionnelle interroge les actifs à des intervalles de 5 à 15 minutes, ce qui signifie que les pannes peuvent passer inaperçues pendant des périodes prolongées. La surveillance en temps réel traite les données en continu, réduisant les délais d'alerte de plusieurs minutes ou heures à quelques secondes.
Quels sont les principaux avantages de la surveillance en temps réel pour les équipes de maintenance ?
Les principaux avantages sont une détection des pannes plus rapide, une réduction du temps moyen de résolution des incidents, une meilleure précision de la maintenance prédictive et un coût total de possession inférieur par rapport aux approches de maintenance réactive.
Quels sont les outils couramment utilisés pour la surveillance en temps réel ?
Les outils courants comprennent Prometheus et Grafana pour la collecte et la visualisation des métriques, Apache Kafka et Apache Flink pour le traitement des flux, InfluxDB et TimescaleDB pour le stockage de séries temporelles, et PagerDuty pour la gestion des incidents et les alertes.
La surveillance en temps réel remplace-t-elle les outils d'analyse des causes profondes ?
Non. La surveillance en temps qu'réel identifie qu'un problème existe et quand il a commencé. Des plateformes d'observabilité qui corrélent les journaux, les traces et les métriques sont toujours nécessaires pour déterminer pourquoi le problème est survenu et comment éviter qu'il ne se reproduise.
Recommandé
- Tendances de la maintenance en 2026 : ce qu'il faut savoir
- Comment optimiser la performance opérationnelle en 2026
- La maintenance intelligente en 2026 : ce qu'il faut savoir
- Gestion des ordres de travail avec tableau de bord en temps réel