En resumen:
- El monitoreo en tiempo real recopila y analiza continuamente los datos operativos para ofrecer información inmediata sobre el rendimiento de los activos. Utiliza agentes ligeros, procesadores de flujo de datos y herramientas de visualización para detectar anomalías de forma rápida, reduciendo los tiempos de inactividad y mejorando la precisión de la mantenimiento. El éxito depende de una arquitectura adecuada, flujos de trabajo integrados y disciplina operativa para obtener resultados óptimos.
El monitoreo en tiempo real se define como la recopilación y análisis automatizados y continuos de datos operativos con latencia mínima, lo que proporciona visibilidad inmediata sobre el rendimiento del activo y el estado del sistema. A diferencia de las verificaciones programadas tradicionales, procesa los datos de telemetría, incluidos los metadatos, registros, trazas y eventos en tiempo real, lo que permite a los profesionales de mantenimiento y los gestores de operaciones detectar anomalías antes de que se agraven. Herramientas como Prometheus, Grafana y PagerDuty son el corazón de la mayoría de las implementaciones modernas, mientras que tecnologías a nivel de núcleo como eBPF han hecho que la recopilación de datos sea mucho menos onerosa en recursos que los métodos de consulta más antiguos.
¿Qué es la monitorización en tiempo real y cómo funciona en entornos operativos?
El monitoreo en tiempo real funciona al desplegar agentes o recopiladores livianos directamente sobre activos, servidores o equipos industriales para recopilar datos de telemetría de forma continua. Estos agentes transmiten los datos a una capa de procesamiento, donde los procesadores de flujo y las bases de datos de series temporales los analizan en cuestión de segundos. Los objetivos de latencia van desde subsegundos hasta 60 segundos., Esto supone una mejora significativa en comparación con los intervalos de votación de 5 a 15 minutos típicos del monitoreo tradicional. Para los equipos de operaciones que gestionan docenas de máquinas o activos en el terreno, esa diferencia determina si una falla se detecta a tiempo o se convierte en un fallo costoso.
La arquitectura técnica que se encuentra detrás del seguimiento eficaz de datos en tiempo real sigue un patrón bien establecido:
- Agentes y coleccionistas poner en marcha en activos supervisados para capturar el uso de la CPU, la temperatura, la presión, las tasas de error y otras métricas operativas
- Herramientas a nivel de kernel como por ejemplo eBPF, que ejecuta programas en un contenedor aislado directamente en el núcleo del sistema operativo, proporcionando una visibilidad profunda con un consumo de CPU casi nulo
- Colas de mensajes como el buffer de Apache Kafka y la ruta de los flujos de datos de alto volumen hacia los procesadores posteriores
- Procesadores de flujo de datos como Apache Flink y Apache Storm aplican reglas de filtrado, agregación y detección de anomalías en tiempo real
- Bases de datos de series temporales InfluxDB y TimescaleDB, por ejemplo, almacenan los datos procesados para consultas y análisis de tendencias.
- Paneles como la visualización en tiempo real de datos por parte de Grafana, mientras que las integraciones con plataformas como PagerDuty activan automáticamente flujos de trabajo de incidentes
Consejo profesional: Al configurar los intervalos de recopilación, recopilar datos cada 10 segundos es una práctica muy común. Ir mucho más rápido sin agregación de datos en el borde puede agotar los recursos de los agentes y disminuir el rendimiento de los propios activos que se están monitoreando.
La lógica de alerta funciona a dos niveles. Los umbrales estáticos se activan cuando una métrica supera un límite fijo, como por ejemplo cuando la temperatura del motor supera los 85 °C. La detección dinámica de anomalías aprende el comportamiento inicial con el tiempo y alerta ante desviaciones incluso cuando no se han alcanzado los umbrales absolutos. Ambos enfoques son necesarios para realizar un seguimiento de rendimiento en tiempo real en entornos industriales.
¿Cuáles son los beneficios del monitoreo en tiempo real para la gestión de activos?
El caso operativo de la monitorización en tiempo real se basa en cuatro resultados medibles: una detección más rápida, una resolución más rápida, menores costes de tiempo de inactividad y una mayor precisión en el mantenimiento.
- Reducción del tiempo medio de detección (MTTD) y del tiempo medio de resolución (MTTR). Capturar las anomalías en su momento permite que los equipos de respuesta a incidentes actúen en cuestión de minutos en lugar de horas, evitando que fallos menores se conviertan en interrupciones en la producción.
- Precisión del mantenimiento predictivo. Implementaciones avanzadas Aumenta la precisión de la conservación predictiva en un 45%% correlacionando los datos de los sensores en tiempo real con los patrones históricos de fallas. Para los profesionales de mantenimiento que gestionan sistemas de HVAC, maquinaria industrial o flotas automotrices, esto reduce directamente los costos de reemplazo no planificados.
- Consolidación de la infraestructura. Las plataformas que unifican los datos de series temporales, gráficos, documentos y vectores en un único motor, como ArcadeDB, consolidan múltiples tipos de datos y reducen el número de herramientas separadas que un equipo debe gestionar.
- Menores costes totales de propiedad. Motores de ingestión de streaming de alto rendimiento ofrecen hasta 60% % de TCO más bajo en comparación con los pipelines de ETL de lote heredados, con un tiempo de entrega de información hasta 10 veces más rápido.
- Mejoras continuas. Los datos operativos en tiempo real se incorporan directamente a los ciclos de reducción de residuos y optimización de procesos, lo que permite a los responsables de operaciones tener la base de datos necesaria para justificar los cambios en el plan de mantenimiento o las decisiones sobre inversiones capitales.
“El cambio hacia la monitorización en tiempo real se debe a la necesidad de minimizar los tiempos de inactividad mediante la detección y resolución más rápida de los incidentes. Esto no es una cuestión de preferencia tecnológica; es una exigencia de la continuidad empresarial para cualquier organización en la que un tiempo de inactividad no planificada tenga un coste financiero directo.
Para los equipos de mantenimiento que gestionan gestión del ciclo de vida de los activos En varios sitios, la importancia de la monitorización en tiempo real va más allá de la detección individual de fallas. Esto crea un ciclo de retroalimentación continuo entre las condiciones sobre el terreno y las decisiones de gestión.
¿Cómo se compara la monitorización en tiempo real con la monitorización tradicional?
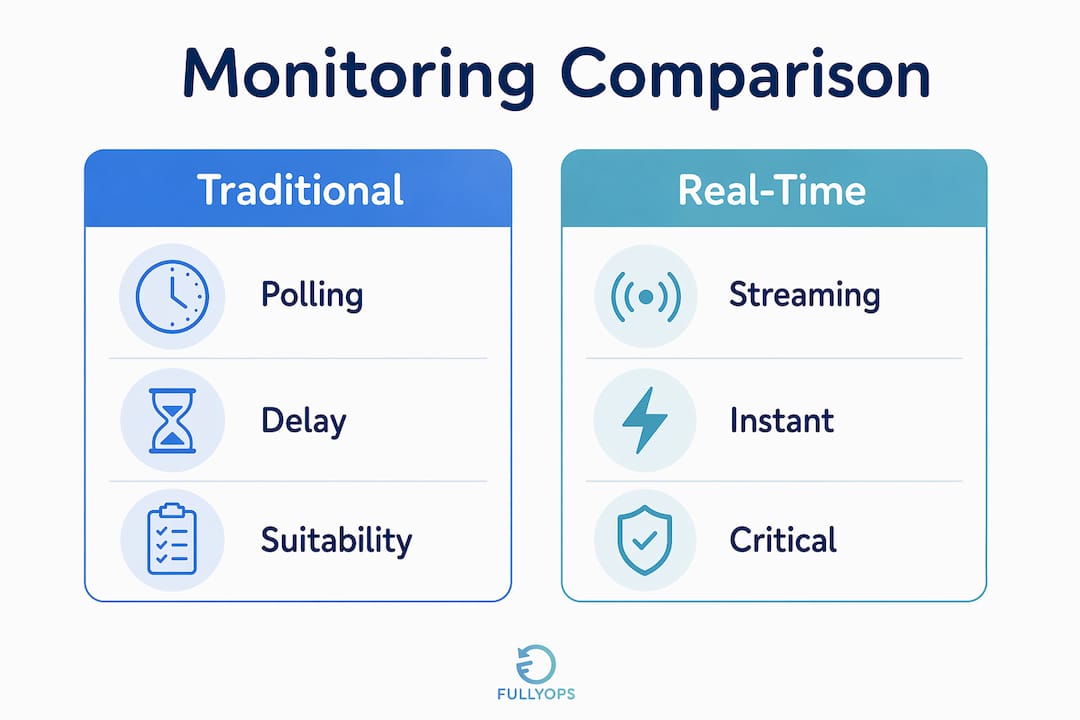
Conocer la diferencia entre los dos enfoques ayuda a los directivos de operaciones a tomar la decisión de inversión adecuada para su entorno.
| Característica | Monitorización tradicional | Control en tiempo real |
|---|---|---|
| Intervalo de encuestas | De 5 a 15 minutos | De un segundo a 60 segundos |
| Retraso en la alerta | Minutos a horas | Segundos a minutos |
| Actualización de datos | Estéril por diseño | Actualidad por diseño |
| La demanda de almacenamiento | Bajar | Mayor nitidez sin filtrado de bordes |
| Calcular el coste | Bajar | De moderada a alta |
| Más adecuado para | Activos estables y de bajo nivel de riesgo | Activos de alto valor, dinámicos o de importancia crítica para la seguridad |
| TCO a lo largo del tiempo | Mayor debido a los costos de los incidentes | Más bajo con una arquitectura adecuada |
Los sistemas de monitoreo tradicionales se aplican en entornos donde los activos cambian lentamente y los breves retrasos en la detección de fallas presentan un bajo riesgo. La monitorización de datos en tiempo real es la opción correcta cuando el fallo de un activo tiene consecuencias financieras, de seguridad o de reputación significativas. Una línea de producción, una unidad de refrigeración en un centro de distribución de alimentos o una bomba de campo en una instalación de tratamiento de agua pertenecen a esta última categoría.
Consejo profesional: No sustituya la monitorización tradicional a gran escala. Use la monitorización en tiempo real para activos críticos y modos de fallo de alta frecuencia, y mantenga las verificaciones programadas para infraestructuras de bajo riesgo y bajo cambio. La estrategia híbrida controla los costes manteniendo al mismo tiempo la cobertura.
El argumento de TCO en favor de los sistemas en tiempo real se fortalece con el tiempo. El coste inicial de la infraestructura de streaming se compensa con reducciones en los costes de reparación de emergencias, las pérdidas en la producción y los horas de trabajo dedicadas a investigar incidentes que habrían podido evitarse.
¿Qué herramientas y pasos son necesarios para implementar el monitoreo en tiempo real?
La implementación efectiva sigue una secuencia estructurada en lugar de un enfoque basado en la tecnología. Los equipos de operaciones que eligen las herramientas antes de definir sus requisitos de datos suelen diseñar su infraestructura de forma excesiva y no cumplen con las expectativas en cuanto a la calidad de las alertas.
Los pasos básicos de implementación son:
- Defina qué es lo que hay que monitorear. Identifique los activos, las métricas y los modos de fallo que presentan el mayor riesgo operativo. La temperatura, la vibración, la presión, las tasas de error y el rendimiento son puntos de partida comunes en los entornos industriales.
- Seleccione los agentes adecuados. Elige agentes que se adapten a tu tipo de activo. Para la infraestructura informática, herramientas como los exportadores de Prometheus o los coleccionadores basados en eBPF funcionan bien. Para el equipo industrial, los conectores OPC-UA o los agentes IoT específicos son más adecuados.
- Elige una arquitectura de streaming. Sistemas de monitoreo en tiempo real Por lo general, incluyen Kafka para la agrupación de mensajes, Flink o Storm para el procesamiento de flujos de datos y InfluxDB o TimescaleDB para el almacenamiento de series temporales. Seleccione los componentes que su equipo pueda operar y mantener.
- Crear paneles de control en Grafana. Grafana se conecta de forma nativa con la mayoría de las bases de datos de series temporales y proporciona la capa de visualización en tiempo real que los equipos de mantenimiento utilizan durante las interrupciones de turno y la respuesta a incidentes.
- Establezca reglas de alerta. Configure tanto los umbrales estáticos como la detección dinámica de anomalías. Dirija las alertas a PagerDuty o a plataformas equivalentes de gestión de incidentes para activar automáticamente la creación de órdenes de trabajo.
- Aplique la agregación de bordes. Equilibrar los intervalos de recopilación de datos y el filtrado previo de los mismos en el borde reduce los costos de almacenamiento y evita la fatiga provocada por las alertas sin sacrificar la precisión de la detección.
Para equipos que gestionan eficiencia en el servicio de campo, Integrar alertas en tiempo real directamente en los flujos de trabajo de gestión de órdenes de trabajo es el paso que convierte los datos de monitoreo en acciones de mantenimiento. Sin esa integración, las alertas siguen siendo notificaciones en lugar de desencadenar acciones de resolución.
¿Qué desafíos deben considerar las empresas con el monitoreo en tiempo real?
El monitoreo en tiempo real no es una solución completa por sí mismo, y varios conceptos erróneos comunes llevan a las organizaciones a implementarlo de manera deficiente.
El concepto erróneo más importante es que la monitorización en tiempo real sustituye la análisis de las causas raíz. La monitorización es el alarme de incendio; la observabilidad es el investigador que explica por qué ocurrió un problema. Herramientas como Grafana y PagerDuty indican que algo está mal y cuándo comenzó. Las plataformas de observabilidad que correlacionan datos de rastreo, registros y métricas indican por qué sucedió algo. Ambos son necesarios para una gestión de incidentes madura.
Otros desafíos que vale la pena abordar antes del despliegue:
- Fatiga por alertas. Sin filtrado inteligente y umbrales bien ajustados, la monitorización de alta frecuencia genera ruido que desensibiliza a los equipos ante las alertas genuinas. La agregación de datos en el borde y el ajuste de la detección de anomalías son las principales medidas de mitigación.
- Compromisos en la forma de obtener los datos. La ingestión basada en push, en la que los agentes envían los datos a un recopilador central, es más escalable para flotas de activos grandes. La ingestión basada en pull, en la que el recopilador solicita los datos a los agentes, es más sencilla de configurar pero genera congestiones a escala.
- Integración con los flujos de trabajo de incidentes. Los datos de monitoreo solo generan valor cuando desencadenan una respuesta definida. procesos de gestión de órdenes de trabajo cierran el ciclo entre la detección y la resolución.
- Costo del almacenamiento a gran escala. Los datos de alta frecuencia procedentes de cientos de activos se acumulan rápidamente. Las políticas de retención, la reducción de la resolución de los datos y el almacenamiento en varios niveles son prácticas estándar para controlar los costes sin perder la visibilidad histórica.
Principales conclusiones
El monitoreo en tiempo real ofrece una ventaja operativa medible solo cuando su arquitectura, la lógica de alerta y los flujos de trabajo de incidentes están diseñados de forma conjunta en lugar de de forma aislada.
| Punto | Detalles |
|---|---|
| La latencia es la diferencia definitoria | El monitoreo en tiempo real ofrece actualizaciones en segundos a 60 segundos, en comparación con los 5 a 15 minutos de los encuestas tradicionales. |
| La precisión de la conservación predictiva mejora | Las implementaciones avanzadas aumentan la precisión de la conservación predictiva en un 45%%, reduciendo los fallos no planificados. |
| La monitorización y la observabilidad son conceptos distintos | El monitoreo de alertas de problemas; las herramientas de observabilidad investigan su causa raíz. Ambos son necesarios. |
| La arquitectura tiene importancia antes que las herramientas | Defina los activos críticos y los modos de fallo antes de seleccionar Kafka, Flink, InfluxDB o Grafana. |
| La integración impulsa la resolución | Conectar las alertas con los flujos de trabajo de órdenes de trabajo convierte los datos de monitoreo en acciones de mantenimiento. |
Por qué el monitoreo en tiempo real solo es tan bueno como el equipo que lo realiza
Desde la estrecha colaboración con los equipos de operaciones y mantenimiento en entornos industriales, el patrón que más a menudo observo es el siguiente: las organizaciones invierten en la infraestructura tecnológica pero infraestiman los procesos operativos que la hacen útil. Un panel de gráficos de Grafana que muestra datos en tiempo real sobre los activos es verdaderamente valioso. Un panel de gráficos de Grafana cuyos alertas se dirigen a una bandeja de entrada que nadie revisa durante los turnos nocturnos no lo es.
Los equipos que extraen el mayor valor del seguimiento del rendimiento en tiempo real son los que lo consideran una disciplina operativa, no una implementación de software. Definieron los trayectos de escalamiento antes de ponerlo en marcha. Revisan los umbrales de alerta trimestralmente. Enlazan las salidas de monitoreo directamente con Programas de mantenimiento predictivo de manera que los datos sirvan para informar la acción, en lugar de quedar almacenados en una base de datos.
La próxima frontera es la detección de anomalías impulsada por la IA, en la que los modelos entrenados en datos históricos específicos del activo sustituyen completamente los umbrales estáticos. Varias plataformas de monitoreo industriales ya están avanzando en esta dirección, y las mejoras en la precisión son significativas. No obstante, la detección impulsada por la IA aún requiere la misma labor fundamental: datos limpios, activos bien definidos y flujos de trabajo integrados para incidentes. La tecnología no sustituye al rigor operativo.
Mi honesto consejo es comenzar con tres a cinco activos críticos, construir primero el flujo de trabajo completo de detección hasta la resolución para esos activos y luego escalar. Las organizaciones que intentan monitorear todo desde el primer día normalmente terminan monitoreando nada de manera efectiva.
— Pedro
Cómo Fullyops apoya la monitorización en tiempo real de los activos en la práctica
Fullyops está diseñado para gerentes de operaciones y profesionales de mantenimiento que necesitan más que un panel de control. La plataforma conecta los datos de los activos en tiempo real con gestión de órdenes de trabajo, la asignación de recursos y la presentación de informes operativos en un único entorno. Cuando se activa una alerta, Fullyops puede activar una orden de trabajo, asignar al técnico adecuado y registrar automáticamente la intervención, cerrando la brecha entre la detección y la resolución que la mayoría de las herramientas de monitorización solo permiten. Para los equipos que buscan alinear su inversión en monitorización con un enfoque estructurado de gestión de activos, Guía de los sistemas de gestión de activos On Fullyops es un punto de partida práctico. También puedes explorar tutorial de asignación de recursos ver cómo los datos operativos en tiempo real se traducen en una planificación de mantenimiento mejorada.
PREGUNTAS FRECUENTES
¿Qué es la monitorización en tiempo real en términos simples?
El monitoreo en tiempo real es la observación automatizada y continua de los datos de rendimiento de los activos o sistemas con un mínimo de retraso, actualizando normalmente cada segundo hasta los 60 segundos. Esto permite a los equipos de operaciones detectar los fallos y las anomalías en su momento, en lugar de detectarlos durante las comprobaciones programadas.
¿Cómo se diferencia la monitorización en tiempo real de la monitorización tradicional?
Las encuestas tradicionales de monitoreo registran los activos a intervalos de entre 5 y 15 minutos, lo que significa que los fallos pueden pasar desapercibidos durante largos periodos. Los procesos de monitoreo en tiempo real registran los datos continuamente, reduciendo los retrasos en la alerta desde minutos o horas hasta segundos.
¿Cuáles son las principales ventajas del monitoreo en tiempo real para los equipos de mantenimiento?
Los beneficios principales son una detección más rápida de fallos, un tiempo medio de resolución de incidentes reducido, una mayor precisión en el mantenimiento predictivo y unos costes totales de propiedad más bajos en comparación con los enfoques de mantenimiento reactivo.
¿Qué herramientas se utilizan comúnmente para la monitorización en tiempo real?
Algunos de los instrumentos más comunes son Prometheus y Grafana para la recopilación y visualización de métricas, Apache Kafka y Apache Flink para el procesamiento de flujos de datos, InfluxDB y TimescaleDB para el almacenamiento de series temporales, y PagerDuty para la gestión de incidentes y la alerta temprana.
¿El monitoreo en tiempo real reemplaza las herramientas de análisis de causas subyacentes?
No. El monitoreo en tiempo real identifica que existe un problema y cuándo comenzó. Las plataformas de observabilidad que correlacionan registros, trazas y métricas siguen siendo necesarias para determinar por qué ocurrió el problema y cómo evitar su reaparición.
Recomendado
- Tendencias de mantenimiento en 2026: lo que necesita saber
- Cómo optimizar el rendimiento operativo en 2026
- Mantenimiento inteligente en 2026: lo que necesitas saber
- Gestión de órdenes de trabajo con panel de control en tiempo real