Resumo:
- A monitorização em tempo real recolhe e analisa continuamente dados operacionais para permitir perceções imediatas sobre o desempenho dos ativos. Utiliza agentes leves, processadores de fluxo e ferramentas de visualização para detetar anomalias rapidamente, reduzindo o tempo de inatividade e melhorando a precisão da manutenção. O sucesso depende de uma arquitetura adequada, fluxos de trabalho integrados e disciplina operacional para obter resultados ótimos.
A monitorização em tempo real é definida como a recolha e análise automatizada e contínua de dados operacionais com latência mínima, proporcionando uma visibilidade imediata sobre o desempenho dos ativos e o estado do sistema. Ao contrário das verificações agendadas tradicionais, processa dados de telemetria, incluindo métricas, registos, vestígios e eventos, à medida que ocorrem, permitindo que os profissionais de manutenção e os gestores de operações detetem anomalias antes que estas se agravem. Ferramentas como o Prometheus, o Grafana e o PagerDuty estão no centro da maioria das implementações modernas, enquanto tecnologias ao nível do kernel, como o eBPF, tornaram a recolha de dados muito menos exigente em termos de recursos do que os métodos de sondagem mais antigos.
O que é a monitorização em tempo real e como funciona em ambientes operacionais?
A monitorização em tempo real funciona através da implementação de agentes ou coletores leves diretamente em ativos, servidores ou equipamentos industriais para recolher dados de telemetria de forma contínua. Estes agentes transmitem os dados para uma camada de processamento, onde os processadores de fluxos e as bases de dados de séries temporais os analisarem no espaço de segundos. Os objetivos de latência variam entre menos de um segundo e 60 segundos, uma melhoria dramática em relação aos intervalos de recolha de dados de 5 a 15 minutos típicos da monitorização tradicional. Para as equipas de operações que gerem dezenas de máquinas ou ativos de campo, essa diferença determina se uma avaria é detetada precocemente ou se se transforma numa falha dispendiosa.
A arquitetura técnica subjacente ao rastreamento eficaz de dados em tempo real segue um padrão bem estabelecido:
- Agentes e cobradores implementar em ativos monitorizados para capturar a utilização de CPU, temperatura, pressão, taxas de erro e outras métricas operacionais
- Ferramentas ao nível do kernel tais como o eBPF executam programas em ambiente seguro ("sandboxed") diretamente no núcleo do sistema operativo, proporcionando uma visibilidade profunda com uma sobrecarga de CPU quase nula
- Filas de mensagens tais como o Apache Kafka armazenam em buffer e encaminham fluxos de dados de alto volume para processadores a jusante
- Processadores de fluxo tais como o Apache Flink e o Apache Storm aplicam regras de filtragem, agregação e deteção de anomalias em movimento
- Bases de dados de séries temporais como o InfluxDB e o TimescaleDB armazenam os dados processados para consulta e análise de tendências
- Painéis como o Grafana visualiza dados em direto, enquanto as integrações de alertas com plataformas como o PagerDuty acionam fluxos de trabalho de incidentes automaticamente
Dica profissional: Ao configurar intervalos de recolha, recolher dados a cada 10 segundos é uma linha de base amplamente utilizada. Ir significativamente mais rápido sem agregação no limite pode esgotar os recursos do agente e degradar o desempenho dos próprios ativos que está a monitorizar.
A lógica de alerta opera a dois níveis. Os limiares estáticos são acionados quando uma métrica ultrapassa um limite fixo, tal como a temperatura de um motor exceder 85°C. A deteção dinâmica de anomalias aprende o comportamento de referência ao longo do tempo e sinaliza desvios mesmo quando os limiares absolutos não são violados. Ambas as abordagens são necessárias para o acompanhamento maduro do desempenho em tempo real em ambientes industriais.
Quais são os benefícios da monitorização em tempo real para a gestão de ativos?
O caso operacional para a monitorização em tempo real assenta em quatro resultados mensuráveis: deteção mais rápida, resolução mais rápida, menores custos de inatividade e maior precisão na manutenção.
- Redução do tempo médio de deteção (MTTD) e do tempo médio de resolução (MTTR). Detetar anomalias à medida que ocorrem permite que as equipas de resposta a incidentes ajam em minutos em vez de horas, evitando que pequenas falhas evoluam para paragens de produção.
- Precisão da manutenção preditiva. Implementações avançadas aumentar a precisão da manutenção preditiva em 45% ao correlacionar dados de sensores em tempo real com padrões de falhas históricos. Para os profissionais de manutenção que gerem sistemas de HVAC, maquinaria industrial ou frotas automóveis, isto reduz diretamente os custos de substituição não planejados.
- Consolidação de infraestruturas. Plataformas que unem dados de séries temporais, de grafos, de documentos e vetoriais num único motor, tal como o ArcadeDB, consolidam múltiplos tipos de dados e reduzem o número de ferramentas separadas que uma equipa tem de gerir.
- Redução do custo total de propriedade. Os motores de ingestão em fluxo de alto desempenho entregam até 60% de redução do TCO em comparação com os pipelines ETL em lote tradicionais, com uma entrega de *insights* até 10 vezes mais rápida.
- Melhoria contínua. Os fluxos de dados operacionais em tempo real alimentam diretamente os ciclos de redução de desperdício e de otimização de processos, fornecendo aos diretores de operações a base empírica para justificar alterações nos cronogramas de manutenção ou decisões de investimento de capital.
“A transição para a monitorização em tempo real é impulsionada pela necessidade de minimizar o tempo de inatividade através de uma deteção e resolução mais rápidas de incidentes. Isto não é uma preferência tecnológica. É um requisito de continuidade de negócio para qualquer organização onde o tempo de inatividade não planeado acarreta um custo financeiro direto.
Para equipas de manutenção que gerem gestão do ciclo de vida dos activos em vários locais, a importância da monitorização em tempo real vai além da deteção de falhas individuais. Cria um ciclo de feedback contínuo entre as condições no terreno e as decisões de gestão.
Como é que a monitorização em tempo real se compara à monitorização tradicional?
Compreender a diferença entre as duas abordagens ajuda os gestores de operações a tomar a decisão de investimento certa para o seu ambiente.
| Característica | Monitorização tradicional | Monitorização em tempo real |
|---|---|---|
| Intervalo de sondagem | 5 a 15 minutos | Menos de um segundo até 60 segundos |
| Atraso de alerta | Minutos para horas | Segundos para minutos |
| Atualidade dos dados | Obsoleto por conceção | Atual por conceção |
| Procura de armazenamento | Mais baixo | Mais alto sem filtragem de extremidades |
| Custo de processamento | Mais baixo | Moderado a elevado |
| Mais adequado para | Ativos estáveis e de baixa criticidade | Ativos de alto valor, dinâmicos ou críticos para a segurança |
| TCO ao longo do tempo | Mais elevado devido aos custos dos incidentes | Reduzir com arquitetura adequada |
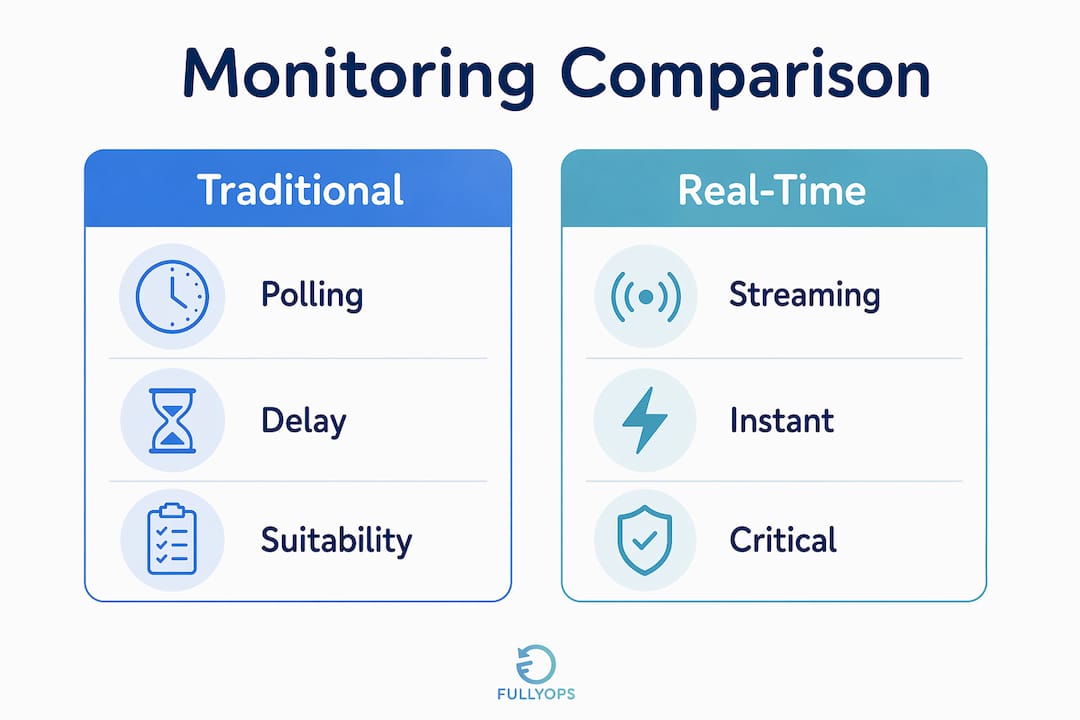
O Entendimento tradicional adequa-se a ambientes onde os ativos mudam lentamente e breves atrasos na deteção de falhas acarretam baixo risco. O acompanhamento de dados em tempo real é a escolha correta quando a falha de um ativo acarreta consequências financeiras, de segurança ou de reputação significativas. Uma linha de produção, uma unidade de refrigeração num centro de distribuição alimentar ou uma bomba de campo numa instalação de tratamento de água enquadram-se todos nesta última categoria.
Dica profissional: Não substitua a monitorização tradicional por atacado. Utilize a monitorização em tempo real para ativos críticos e modos de falha de alta frequência, e mantenha as verificações agendadas para infraestruturas de baixo risco e baixa alteração. A abordagem híbrida controla os custos enquanto mantém a cobertura.
O argumento do Custo Total de Propriedade (TCO) para os sistemas em tempo real fortalece-se ao longo do tempo. O custo inicial da infraestrutura de *streaming* é compensado pelas reduções nos custos de reparação de emergência, nas perdas de produção e nas horas de trabalho gastas a investigar incidentes que poderiam ter sido evitados.
Que ferramentas e passos são necessários para implementar a monitorização em tempo real?
A implementação eficaz segue uma sequência estruturada em vez de uma abordagem centrada na tecnologia. As equipas de operações que selecionam ferramentas antes de definirem os seus requisitos de dados acabam invariavelmente por sobredimensionar a sua stack e ficar aquém no que respeita à qualidade dos alertas.
Os passos principais de implementação são:
- Definir o que monitorizar. Identifique os ativos, as métricas e os modos de falha que apresentam o maior risco operacional. A temperatura, a vibração, a pressão, as taxas de erro e o rendimento são pontos de partida comuns para ambientes industriais.
- Selecionar agentes adequados. Escolha agentes que correspondam ao seu tipo de ativo. Para infraestrutura de TI, ferramentas como exportadores do Prometheus ou coletores baseados em eBPF funcionam bem. Para equipamentos industriais, conectores OPC-UA ou agentes de IoT específicos são mais apropriados.
- Escolha uma arquitetura de transmissão em fluxo. Sistemas de monitorização em tempo real normalmente incluem o Kafka para o encaminhamento de mensagens, o Flink ou o Storm para o processamento de fluxos de dados, e o InfluxDB ou o TimescaleDB para o armazenamento de séries temporais. Selecione componentes que a sua equipa consiga operar e manter.
- Construa dashboards no Grafana. O Grafana liga-se nativamente à maioria das bases de dados de séries temporais e fornece a camada de visualização em tempo real que as equipas de manutenção utilizam durante as passagens de turno e a resposta a incidentes.
- Estabelecer regras de alerta. Configure limiares estáticos e deteção dinâmica de anomalias. Encaminhe alertas para o PagerDuty ou plataformas de gestão de incidentes equivalentes para acionar a criação automática de ordens de trabalho.
- Aplicar agregação de arestas. O equilibrio entre os intervalos de recolha de dados e a pré-filtragem de dados na *edge* reduz os custos de armazenamento e evita a fadiga de alertas sem sacrificar a precisão da deteção.
Para equipas que gerem eficiência do serviço de campo, a integração de alertas em tempo real diretamente nos fluxos de trabalho de gestão de ordens de trabalho é o passo que converte os dados de monitorização em ações de manutenção. Sem essa integração, os alertas continuam a ser notificações em vez de disparadores para a resolução.
Que desafios devem as empresas considerar com a monitorização em tempo real?
A monitorização em tempo real não é, por si só, uma solução completa, e vários equívocos comuns levam as organizações a implementá-la de forma deficiente.
O equívoco mais significativo é que a monitorização em tempo real substitui a análise de causa raiz. A monitorização é o alarme de incêndio; a observabilidade é o investigador que explica porque ocorreu um problema. Ferramentas como o Grafana e o PagerDuty dizem-lhe que algo está errado e quando começou. As plataformas de observabilidade que correlacionam vestígios, registos e métricas dizem-lhe o porquê. Ambas são necessárias para uma gestão de incidentes madura.
Outros desafios que vale a pena abordar antes da implementação:
- Fadiga de alertas. Sem filtragem inteligente e limiares bem ajustados, a monitorização de alta frequência gera ruído que dessensibiliza as equipas para os alertas genuínos. A agregação na periferia e o ajuste da deteção de anomalias são as principais mitigações.
- Compromissos dos métodos de ingestão de dados. A ingestão baseada em *push*, em que os agentes enviam dados para um coletor central, escala melhor para grandes frotas de ativos. A ingestão baseada em *pull*, em que o coletor solicita dados aos agentes, é mais simples de configurar, mas cria estrangulamentos à escala.
- Integração com fluxos de trabalho de incidentes. Os dados de monitorização só criam valor quando despoletam uma resposta definida. Ligar os alertas a processos de gestão de ordens de trabalho fecha o ciclo entre a deteção e a resolução.
- Custo de armazenamento à escala. Os dados de alta frequência de centenas de ativos acumulam-se rapidamente. As políticas de retenção, a redução de amostragem de dados e o armazenamento em camadas são práticas padrão para controlar custos sem perder a visibilidade histórica.
Principais conclusões
A monitorização em tempo real só proporciona uma vantagem operacional mensurável quando a respetiva arquitetura, a lógica de alertas e os fluxos de trabalho de incidentes são desenhados em conjunto e não de forma isolada.
| Ponto | Detalhes |
|---|---|
| A latência é a diferença fundamental | A monitorização em tempo real visa atualizações inferiores a um segundo a 60 segundos, em comparação com 5 a 15 minutos para a sondagem tradicional. |
| A precisão da manutenção preditiva melhora | As implementações avançadas aumentam a precisão da manutenção preditiva em 45%, reduzindo as falhas não planeadas. |
| A monitorização e a observabilidade são distintas | As notificações de monitorização alertam para problemas; as ferramentas de observabilidade investigam a respetiva causa raiz. Ambas são necessárias. |
| A arquitetura importa antes das ferramentas | Defina ativos críticos e modos de falha antes de selecionar o Kafka, Flink, InfluxDB ou Grafana. |
| A integração impulsiona a resolução | A ligação de alertas a fluxos de trabalho de ordens de trabalho converte dados de monitorização em ação de manutenção. |
Porque a monitorização em tempo real vale apenas o que a equipa por trás dela vale
A partir do trabalho em estreita colaboração com equipas de operações e manutenção em ambientes industriais, o padrão que vejo mais frequentemente é este: as organizações investem na pilha tecnológica e desinvestem nos processos operacionais que a tornam útil. Um painel do Grafana que mostra dados de ativos em tempo real é genuinamente valioso. Um painel do Grafana cujos alertas são encaminhados para uma caixa de entrada que ninguém consulta durante os turnos da noite não o é.
As equipas que extraem mais valor do acompanhamento de desempenho em tempo real são aquelas que o tratam como uma disciplina operacional, e não como uma implementação de software. Definem vias de escalamento antes de entrarem em funcionamento. Reveem os limiares de alerta trimestralmente. Ligam os resultados da monitorização diretamente a planos de manutenção preditiva para que os dados informem a ação em vez de ficarem numa base de dados.
A próxima fronteira é a deteção de anomalias impulsionada por IA, onde modelos treinados com dados históricos específicos de ativos substituem totalmente os limiares estáticos. Várias plataformas de monitorização industrial já estão a avançar nessa direção, e as melhorias na precisão são significativas. Dito isto, a deteção impulsionada por IA ainda requer o mesmo trabalho fundamental: dados limpos, ativos bem definidos e fluxos de trabalho de incidentes integrados. A tecnologia não substitui o rigor operacional.
O meu conselho sincero é começar com três a cinco ativos críticos, construir primeiro o fluxo de trabalho completo, desde a deteção até à resolução, para esses ativos, e só depois escalar. As organizações que tentam monitorizar tudo desde o primeiro dia normalmente acabam por não monitorizar nada de forma eficaz.
— Pedro
Como a Fullyops apoia a monitorização de ativos em tempo real na prática
A Fullyops foi criada para gestores de operações e profissionais de manutenção que precisam de mais do que um painel de monitorização. A plataforma liga dados de ativos em tempo real a gestão de ordens de trabalho, a alocação de recursos e os relatórios operacionais num único ambiente. Quando um alerta é disparado, o Fullyops pode acionar uma ordem de trabalho, atribuir o técnico certo e registar a intervenção automaticamente, colmatando a lacuna entre a deteção e a resolução que a maioria das ferramentas exclusivamente de monitorização deixa em aberto. Para equipas que pretendem alinhar o seu investimento em monitorização com uma abordagem estruturada de gestão de ativos, o guia de sistemas de gestão de ativos na Fullyops é um ponto de partida prático. Também pode explorar o tutorial de atribuição de recursos para ver como os dados operacionais em tempo real se traduzem num melhor planeamento da manutenção.
FAQ
O que é a monitorização em tempo real em termos simples?
Oª monitorização em tempo real é a observação automatizada e contínua dos dados de desempenho de ativos ou sistemas com um atraso mínimo, atualizando tipicamente a cada segundo ou 60 segundos. Permite que as equipas de operações detetem falhas e anomalias à medida que ocorrem, em vez de as descobrirem durante verificações agendadas.
Como é que a monitorização em tempo real difere da monitorização tradicional?
A monitorização tradicional interroga os ativos em intervalos de 5 a 15 minutos, o que significa que as falhas podem passar despercebidas durante períodos prolongados. A monitorização em tempo real processa os dados continuamente, reduzindo os atrasos nos alertas de minutos ou horas para segundos.
Quais são os principais benefícios da monitorização em tempo real para as equipas de manutenção?
Os principais benefícios são uma deteção de avarias mais rápida, um tempo médio de resolução de incidentes reduzido, maior precisão na manutenção preditiva e um custo total de propriedade inferior em comparação com as abordagens de manutenção reativa.
Que ferramentas são habitualmente utilizadas para monitorização em tempo real?
As ferramentas comuns incluem o Prometheus e o Grafana para a recolha e visualização de métricas, o Apache Kafka e o Apache Flink para o processamento de fluxos, o InfluxDB e o TimescaleDB para o armazenamento de séries temporais, e o PagerDuty para a gestão de incidentes e alertas.
A monitorização em tempo real substitui as ferramentas de análise de causa raiz?
Não. A monitorização em tempo real identifica que existe um problema e quando começou. As plataformas de observabilidade que correlacionam registos, vestígios e métricas continuam a ser necessárias para determinar porque ocorreu o problema e como prevenir a recorrência.
Recomendado
- Tendências de manutenção em 2026: o que precisa de saber
- Como otimizar o desempenho operacional em 2026
- Manutenção inteligente em 2026: o que precisa de saber
- Gestão de ordens de trabalho com painel de controlo em tempo real