Resumo:
- Estratégias de manutenção pró-ativa, como a RCM, PdM e PM, melhoram a fiabilidade dos equipamentos e reduzem custos.
- A implementação eficaz requer a avaliação da criticidade dos ativos, procedimentos normalizados e monitorização de KPI.
- Cultivar uma forte cultura de manutenção com o apoio da liderança e a melhoria contínua impulsiona o sucesso a longo prazo.
Melhores práticas de manutenção: Aumente a eficiência e a vida útil dos ativos
As operações industriais estão a tornar-se mais complexas a cada ano, e a pressão para reduzir o tempo de inatividade não planeado, controlando simultaneamente os custos, nunca foi tão alta. No entanto, muitos gestores de operações ainda dependem de hábitos reativos, corrigindo falhas à medida que ocorrem em vez de construírem um programa estruturado e proativo. A diferença entre as fábricas de topo e as instalações medianas é mensurável e significativa, e resume-se frequentemente a quais as estratégias de manutenção que estão em vigor, com que consistência são aplicadas e se as métricas de desempenho corretas orientam a tomada de decisões. Este artigo fornece-lhe um enquadramento fundamentado em evidências que abrange critérios de seleção, metodologias principais, passos de implementação e ferramentas de benchmarking para construir um programa de manutenção orientado para resultados.
Índice
- Definição de critérios de seleção para estratégias de manutenção
- Metodologias centrais de manutenção: PM, PdM e RCM explicadas
- Implementar as melhores práticas de manutenção: Passos para o sucesso operacional
- Gestão comparativa e melhoria contínua na gestão de manutenção
- Porque é que a verdadeira revolução da manutenção começa na cultura, e não apenas na tecnologia
- Acelere as suas melhorias de manutenção com soluções especializadas
- Perguntas mais frequentes
Principais conclusões
| Ponto | Detalhes |
|---|---|
| Priorizar ativos críticos | Concentrar recursos onde as falhas têm maior impacto assegura os melhores retornos do seu programa de manutenção. |
| Associar método ao ativo | Escolha abordagens preventivas, preditivas ou híbridas com base no valor do ativo e no risco de falha. |
| Monitorizar e avaliar KPIs | A monitorização de OEE, MTBF e conformidade permite medir o progresso e detetar lacunas em relação aos melhores desempenhos da indústria. |
| Invista em sistemas digitais | Um CMMS bem implementado e a qualidade dos dados são bases essenciais para o sucesso da manutenção a longo prazo. |
| A cultura impulsiona os resultados | A valorização de competências da equipa, o apoio da liderança e uma mentalidade de melhoria contínua são as verdadeiras chaves para a eficiência sustentada. |
Definição de critérios de seleção para estratégias de manutenção
Nem todos os ativos são iguais, e nem todas as estratégias de manutenção se adequam a todas as situações. Antes de escolher entre a manutenção preventiva (MP), a manutenção preditiva (PdM) ou a manutenção centrada na fiabilidade (RCM), os gestores de operações precisam de um conjunto claro de critérios para orientar essa decisão de forma objetiva. Sem este enquadramento, as equipas arriscam-se a fazer uma manutenção excessiva de ativos de baixa criticidade, enquanto negligenciam o equipamento cuja avaria causaria mais danos.
O primeiro e mais importante critério é criticidade do ativo. Pergunte o que acontece quando este ativo falha: pára uma linha de produção inteira, cria um perigo para a segurança ou simplesmente desacelera um posto de trabalho? As respostas moldam diretamente quantos recursos investir na manutenção desse ativo. Após a criticidade, considere estes fatores de seleção adicionais:
- Valor do ativo e custo de substituiçãoO equipamento de alto valor justifica estratégias sofisticadas de monitorização e prevenção.
- Consequências da falhaOs impactos de segurança, ambientais, regulamentares e financeiros influenciam todos a seleção da estratégia.
- Requisitos regulamentaresCertos setores, tais como o processamento de alimentos e o fabrico farmacêutico, exigem cronogramas de inspeção específicos e registos de auditoria.
- Disponibilidade de dadosA PdM requer uma saída de sensores fiável e dados históricos de falhas; sem eles, a PM pode ser o ponto de partida mais prático.
- Prontidão da força de trabalho e da tecnologiaAté a estratégia mais avançada falha se os técnicos não tiverem a formação ou as ferramentas para a executar.
De acordo com 7 principais boas práticas Para os programas de manutenção industrial, as equipas líderes prioritizam os ativos por criticidade, padronizam os procedimentos operacionais padrão e listas de verificação, integram sistemas informatizados de gestão da manutenção (CMMS) ou plataformas de gestão de ativos empresariais (EAM) para automação e programação, formam a sua mão de obra de forma consistente, implementam estratégias híbridas de manutenção preventiva e preditiva, monitorizam KPIs continuamente e promovem a melhoria contínua através da análise de causa raiz. Estes sete pilares fornecem uma base de partida sólida para qualquer processo de seleção.
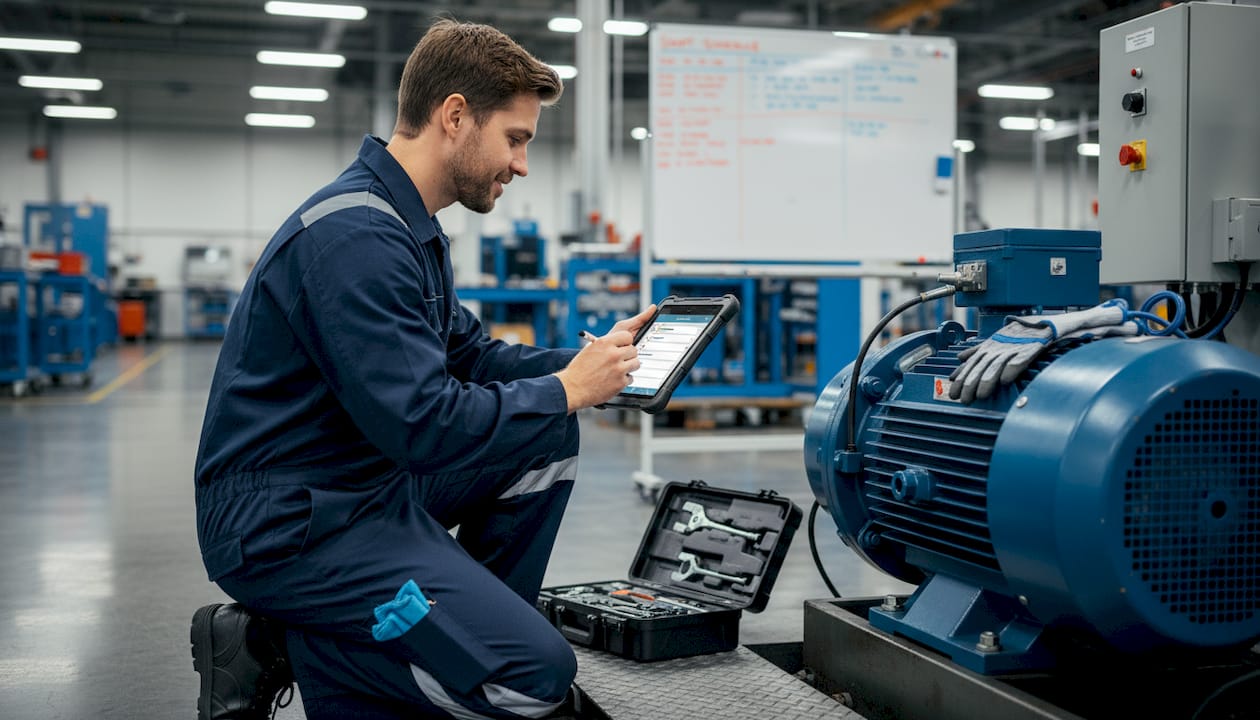
Definir PM, PdM e RCM nesta fase também importa. A PM utiliza calendários baseados no tempo ou na utilização para prevenir falhas antes de estas ocorrerem. A PdM utiliza dados de condição em tempo real para acionar a manutenção apenas quando limiares específicos são atingidos. A RCM analisa sistematicamente cada modo de falha para selecionar a estratégia ideal para essa falha específica. Integrar o conhecimento destas três abordagens nos seus critérios de seleção evita que as equipas recorram por defeito a um único método quando uma solução em camadas ou híbrida seria muito mais adequada.
Dica profissional: Antes de dimensionar o seu programa de manutenção para todos os ativos, teste a abordagem escolhida nos dez ativos mais críticos da sua instalação. Isto limita o risco, gera dados do mundo real e aumenta a confiança da equipa antes de um lançamento mais abrangente.
A normalização de listas de verificação e a integração de ferramentas digitais no seu fluxo de trabalho também dão frutos aqui. Uma bem estruturada processo de manutenção preventiva reduz a variabilidade, captura o conhecimento institucional e cria a pista de auditoria que os reguladores e as equipas de qualidade esperam.
Metodologias centrais de manutenção: PM, PdM e RCM explicadas
Compreender a mecânica de cada metodologia é essencial antes de comprometer recursos. Cada abordagem tem pontos fortes claros, limitações genuínas e um âmbito definido de tipos de ativos e contextos operacionais onde proporciona o máximo valor.
Manutenção preventiva (MP) funciona segundo cronogramas fixos com base no tempo decorrido ou na utilização medida em horas, ciclos ou quilómetros. É simples de planear, fácil de atribuir e resulta bem para ativos com padrões de desgaste previsíveis, tais como tapetes transportadores, filtros e rolamentos lubrificados. O risco é a sobre-manutenção: as tarefas realizadas com demasiada frequência acrescentam custos desnecessários e, paradoxalmente, podem introduzir falhas ao perturbar componentes que estavam a funcionar dentro da tolerância.
Manutenção preditiva (PdM) desvia a calendarização da manutenção para limiares de condição através de sensores que monitorizam a vibração, a temperatura, a qualidade do óleo ou assinaturas elétricas. Como o trabalho só é despoletado quando as leituras se aproximam dos limiares de falha, a manutenção preditiva evita intervenções desnecessárias e prolonga a vida útil dos ativos com maior precisão. A contrapartida é o investimento inicial em hardware de sensores, infraestrutura de dados e capacidade analítica.
Manutenção centrada na fiabilidade é a abordagem mais sistemática. Em vez de aplicar uma estratégia genérica, a RCM analisa as funções de cada ativo, as formas como essas funções podem falhar e as consequências de cada modo de falha. Em seguida, seleciona a melhor combinação de manutenção preventiva, preditiva, monitorização de condição ou funcionamento até à falha para esse modo de falha específico. Como boas práticas para fábricas em 2026 confirmação: as principais metodologias abrangem MP (baseada no tempo e na utilização), PdM (baseada no estado através de sensores) e RCM (análise centrada na função que seleciona a estratégia ideal por modo de falha).
A RCM e a PdM não são abordagens concorrentes: muitas vezes são complementares. A RCM define qual a estratégia adequada a cada modo de falha, e a PdM fornece os dados de condição que tornam essa estratégia executável com precisão.
| Metodologia | Typical cost | ROI potential | Best asset fit | Risk profile |
|---|---|---|---|---|
| Preventive (PM) | Low to medium | Moderado | Predictable wear assets | Risk of over-maintenance |
| Predictive (PdM) | Medium to high | High (up to 10x) | High-value, monitored assets | Data quality dependency |
| RCM | High (upfront) | Very high | Complex, critical systems | Requires analytical expertise |
A common misconception is that PdM is always superior to PM. In reality, PdM only outperforms PM when there is enough high-quality sensor data and analytical capacity to act on it. For low-criticality, low-cost assets with predictable failure patterns, PM is more efficient. Hybrid approaches, where PM covers routine tasks and PdM monitors critical parameters in parallel, consistently outperform single-method programmes. Refer to the passos de manutenção preventiva that support PM as a foundation layer within a broader strategy.
Implementar as melhores práticas de manutenção: Passos para o sucesso operacional
Choosing the right methodology means little without a disciplined, structured implementation. Teams that rush from strategy selection to full deployment without intermediate steps routinely struggle with inconsistent results, low technician buy-in, and poor data quality that undermines future decision making.
A proven sequence for embedding best practices into daily operations follows these steps, aligned with RCM implementation guidance from reliability engineering practice:
- Conduct asset criticality analysis: Rank all assets using a structured criticality matrix that scores safety impact, production impact, failure frequency, and repair cost. This prioritises where to focus your programme first.
- Perform functional failure analysis and FMEA: For each critical asset, identify its required functions, the ways those functions can fail, and the effects of each failure. Failure mode and effects analysis (FMEA) quantifies risk so strategy selection is evidence-based, not instinct-based.
- Select the maintenance mix: Assign PM, PdM, condition monitoring, or run-to-fail to each failure mode based on criticality, failure pattern, and data availability. Document the reasoning for each decision.
- Deploy with standardised work orders: Translate each maintenance task into a standardised work order with clear instructions, required tools, safety steps, and estimated time. This is where CMMS integration proves essential for scheduling and tracking.
- Monitor KPIs from day one: Establishing performance baselines before the programme matures gives you the comparison point you need to demonstrate improvement.
- Refine through root cause analysis: When failures do occur or KPIs slip, treat each event as a learning opportunity rather than a crisis. Structured root cause analysis prevents recurrence and feeds continuous improvement.
The KPIs your team tracks will define what you can improve. The table below shows key maintenance metrics alongside top-performer and industry-average benchmarks:
| KPI | Top performer target | Média da indústria |
|---|---|---|
| Reactive work (%) | Less than 10 to 15% | 25 to 35% |
| PM compliance (%) | Greater than 90 to 95% | 60 to 75% |
| Overall equipment effectiveness (OEE) | Greater than 85% | 60 to 75% |
| Mean time between failures (MTBF) | Greater than 2,000 to 3,000 hrs | 500 to 1,500 hrs |
| Mean time to repair (MTTR) | Less than 2 to 4 hrs | 6 to 12 hrs |
| Maintenance cost as % of RAV | 2 to 3% | 3 to 5% |
Pro Tip: CMMS data quality is the foundation of KPI reliability. Invest in technician training on accurate data entry before focusing on dashboard sophistication. A beautiful dashboard built on poor data leads to poor decisions.
A frequently underestimated barrier to implementation is cultural resistance. Technicians who have worked reactively for years may view detailed SOPs and digital reporting as administrative burden rather than professional tools. Addressing this requires leadership clarity, visible management support, and early wins that demonstrate the value of the new approach. Use the passos de manutenção preventiva framework as a communication tool to show technicians how structured processes reduce their emergency call-outs and after-hours disruptions.
Gestão comparativa e melhoria contínua na gestão de manutenção
A maintenance programme without benchmarking is a programme without direction. Knowing your current performance is only useful when you can compare it against credible external standards and track progress over time. Benchmarking transforms KPIs from internal reporting metrics into strategic decision-making tools.
The metrics that matter most for benchmarking are those that capture both reliability and efficiency. According to maintenance KPI benchmarking data, top-performing plants achieve reactive work below 10 to 15%, PM compliance above 90 to 95%, OEE above 85%, MTBF exceeding 2,000 to 3,000 hours, MTTR below 2 to 4 hours, and maintenance cost at 2 to 3% of replacement asset value (RAV). Average plants, by contrast, see 25 to 35% reactive work, OEE of 60 to 75%, and maintenance costs of 3 to 5% of RAV.
Those gaps represent substantial financial and operational opportunity. A facility spending 5% of RAV on maintenance costs when top performers spend 2 to 3% may be wasting millions annually in avoidable labour, spare parts, and emergency procurement. Closing even a portion of that gap through improved PM compliance and reduced reactive work delivers measurable bottom-line returns.
Target ranges to guide your benchmarking programme include:
- OEE: Aim for above 75% as an intermediate target if you are currently below 65%.
- MTBF: Track trends monthly; a consistently rising MTBF indicates your PM and PdM investments are working.
- MTTR: Reductions here reflect improvements in parts availability, technician skill, and procedure clarity.
- PM compliance: Below 80% signals scheduling, resourcing, or prioritisation problems that need immediate attention.
- Reactive work percentage: Every percentage point reduction here represents a shift from costly emergency response to planned, controlled intervention.
Using industry maintenance benchmarks alongside your internal data gives you an objective external reference point that internal teams cannot dispute. External benchmarking data is particularly persuasive when making the business case for CMMS investment or additional maintenance headcount to senior leadership.
Routine audits and root cause analysis sit at the core of continuous improvement. Schedule quarterly reviews of each KPI, identify the top three drivers of underperformance, and assign corrective actions with clear owners and deadlines. Structured maintenance cost tracking gives you the financial dimension of this analysis, while ferramentas de acompanhamento de manutenção support the operational data collection that makes KPI reviews credible.
Porque é que a verdadeira revolução da manutenção começa na cultura, e não apenas na tecnologia
There is a persistent belief in industrial maintenance circles that deploying better software, sensors, or analytical tools is the primary driver of performance improvement. The evidence tells a more nuanced story. Technology is an enabler, but it is people and culture that determine whether that technology is used consistently, intelligently, and to its full potential.
Leadership must prioritise training, cross-team collaboration, and continuous improvement to overcome the reactive habits that are deeply embedded in many industrial organisations. Without visible leadership commitment, even the most capable CMMS becomes a data entry burden rather than a decision-support platform.
The highest-performing maintenance teams share characteristics that have little to do with their choice of software. They conduct structured post-failure reviews where technicians are encouraged to contribute without fear of blame. They create mentoring pathways where experienced engineers transfer tacit knowledge to newer team members. They share KPI dashboards openly across shifts and departments, building collective accountability rather than siloing performance data.
Root cause analysis, when genuinely embedded in team culture rather than performed as a compliance exercise, consistently delivers more sustained improvement than any single tool upgrade. SOP adherence, which requires buy-in rather than enforcement, reduces variability in ways that no monitoring system can compensate for. Maintenance tracking technology amplifies these cultural strengths, but it cannot substitute for them. The teams that win long-term are those who invest in both dimensions simultaneously.
Acelere as suas melhorias de manutenção com soluções especializadas
Ready to put these strategies to work? FullyOps provides operations managers and maintenance teams with the digital tools and structured processes needed to move from reactive maintenance to a proactive, data-driven programme. From a lista de verificação de conformidade de manutenção that standardises your SOPs and audit trails, to an inventory tracking guide that ensures parts availability never delays a critical repair, and ferramentas de acompanhamento de manutenção that give your team real-time visibility into work orders and KPIs, FullyOps is built to support every layer of the maintenance best practices framework covered in this article. Explore the platform and take the next step towards measurable operational improvement.
Perguntas mais frequentes
Qual é a diferença entre manutenção preventiva e preditiva?
A manutenção preventiva utiliza calendários baseados no tempo ou na utilização para realizar tarefas a intervalos fixos, enquanto a manutenção preditiva utiliza dados de sensores baseados no estado para desencadear intervenções apenas quando as leituras do equipamento se aproximam dos limiares de falha, reduzindo as intervenções desnecessárias.
Que KPIs é que as equipas de manutenção devem monitorizar para obterem os melhores resultados?
Monitorize o OEE, o MTBF, o MTTR, a percentagem de trabalho reativo e a conformidade da manutenção preventiva como o seu conjunto principal; as fábricas de alto desempenho atingem um OEE superior a 85%, um MTBF superior a 2.000 horas e um trabalho reativo inferior a 15%, dando-lhe objetivos claros pelos quais trabalhar.
Como devo priorizar quais ativos manter?
Utilize uma análise de criticidade de ativos que pontue cada equipamento quanto ao impacto na segurança, impacto na produção, frequência de falhas e custo de reparação; priorizar por criticidade garante que os seus ativos de maior risco recebam a atenção mais rigorosa primeiro.
Por que é que a maioria das falhas em instalações industriais não está relacionada com a idade dos ativos?
Research shows that most equipment failures are not age-related, meaning time-based replacement schedules alone are inefficient; risk management strategies that address specific failure modes deliver far better outcomes than focusing on asset age as the primary trigger for intervention.
Recomendado
- Guia de fluxo de trabalho de manutenção de activos para uma eficiência óptima
- Passos essenciais de manutenção preventiva: maximize a fiabilidade
- 7 Estratégias comprovadas de gestão de recursos para a eficiência dos activos