En resumen:
- Los datos impulsan la confiabilidad de los equipos al cambiar el mantenimiento de los calendarios a acciones basadas en condiciones que previenen fallas.
- La integración adecuada de datos y la inteligencia artificial explicable generan confianza, lo que permite a los equipos de mantenimiento tomar decisiones precisas y oportunas.
Los datos son el principal motor de la fiabilidad de los equipos, transformando el mantenimiento de una obligación basada en el calendario en una disciplina guiada por las condiciones que se anticipa a los fallos antes de que ocurran. El papel de los datos en la fiabilidad de los equipos se reconoce ahora en todos los sectores industriales como la base para mantenimiento predictivo y basado en la condición estrategias. Los marcos de organismos como el IEEE y la AIChE apuntan al monitoreo en tiempo real y al análisis de datos estructurados como la vía recomendada para reducir el tiempo de inactividad no planificado. Los gestores de mantenimiento que actúan basándose en datos de calidad, en lugar de en calendarios fijos, logran sistemáticamente menores costos y una mayor disponibilidad de los activos.
¿Cómo mejora el análisis de datos la fiabilidad de los equipos?
El análisis de datos para la fiabilidad de los equipos se centra en dos métricas fundamentales: el tiempo medio entre fallos (MTBF) y el tiempo medio de reparación (MTTR). El MTBF mide cuánto tiempo funciona un activo antes de fallar. El MTTR mide la rapidez con la que el equipo lo restaura. Juntas, ofrecen a los gestores de mantenimiento una base fáctica para comparar el rendimiento de los activos a lo largo del tiempo e identificar qué máquinas presentan el mayor riesgo.
Los datos que alimentan estas métricas provienen de sensores físicos conectados a activos críticos. Vibración, temperatura y acústica cada uno produce firmas físicas distintas que preceden al fallo mecánico. Un cojinete que funciona caliente o vibra a una frecuencia anormal mostrará ese patrón en los datos de los sensores días o semanas antes de averiarse. Ese margen es donde los equipos de mantenimiento pueden actuar.
Dos modelos analíticos convierten los datos brutos de los sensores en decisiones de mantenimiento. La detección de anomalías señala las lecturas que se desvían de los rangos operativos normales. La predicción de la vida útil restante (RUL) calcula cuánta vida útil le queda a un activo antes de que sea necesaria una intervención. Los modelos de RUL precisos dependen totalmente de conjuntos de datos de alta calidad y bien conservados. Una mala calidad de los datos produce predicciones poco fiables, lo que erosiona la confianza en todo el programa.
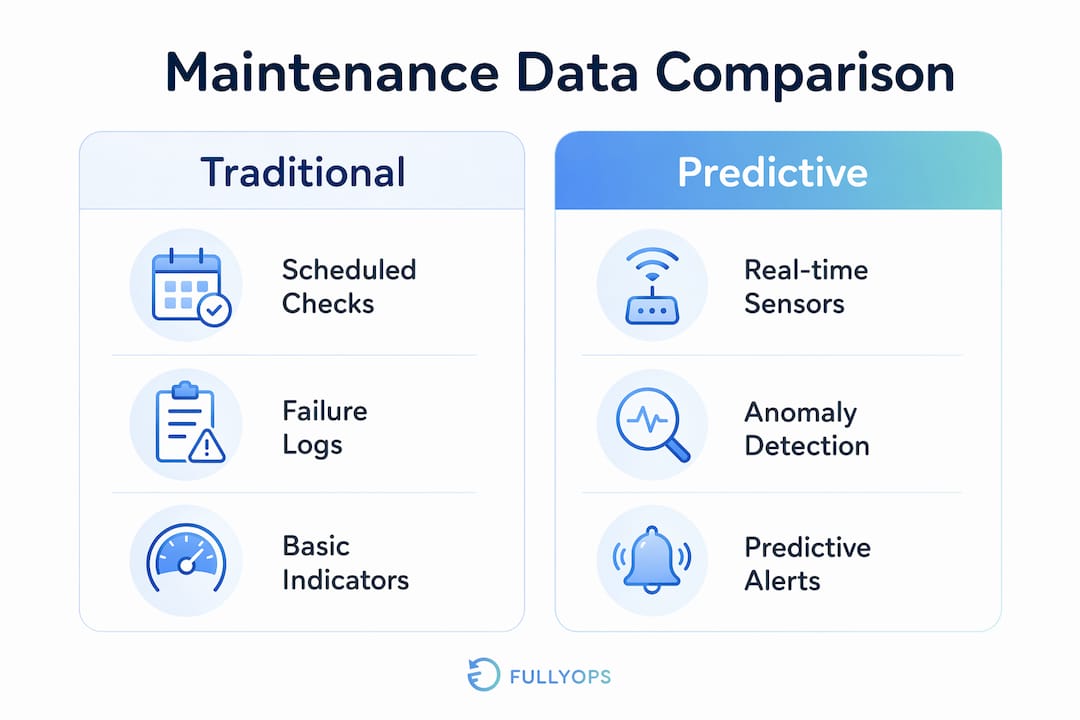
La tabla a continuación contrasta lo que los datos de mantenimiento tradicional capturan frente a lo que ofrece el análisis predictivo.
| Tipo de métrica | Datos de mantenimiento tradicional | Resultado de análisis predictivo |
|---|---|---|
| Indicador de fallo | Registro de orden de trabajo correctiva | Puntuación de anomalía de la transmisión de sensores en vivo |
| Momento de la acción | Intervalo de calendario fijo | Alerta activada por condición |
| Vista del estado de los activos | Registro de desglose histórico | Índice de salud en tiempo real y estimación de la RUL |
| Visibilidad de costos | Costo de reparación reactiva por incidente | Ahorro de costos proyectado por intervención |
| Base de decisión | Experiencia y cronograma del ingeniero | Recomendación de modelo de datos con puntuación de confianza |
¿Qué frameworks admiten una integración de datos eficaz para la fiabilidad?
La gestión moderna de la fiabilidad no padece de falta de datos. Las plantas modernas generan una gran cantidad de datos operativos sino que carecen de los marcos estructurados para conectarla con las decisiones. El resultado son silos de datos: fuentes de sensores, sistemas informatizados de gestión del mantenimiento (CMMS), plataformas de gestión de activos empresariales (EAM) y herramientas de análisis predictivo que operan de forma independiente.
El concepto de un tejido de datos unificado aborda esto directamente. A tejido de datos unificado conecta sistemas de mantenimiento aislados y supervisión en tiempo real en un ecosistema de apoyo a la decisión único y coherente. En lugar de exigir a los ingenieros que cambien entre cinco plataformas para formarse una idea completa de un solo activo, la infraestructura presenta la información adecuada en un solo lugar.
Escalar esta arquitectura de una sola planta a una empresa requiere una plataforma de operaciones empresariales (EOP) integrada. Una EOP conecta los datos de sensores a nivel de sitio con la gestión de activos corporativos y los informes financieros. Los gestores de mantenimiento obtienen visibilidad en múltiples instalaciones sin perder la granularidad necesaria para la toma de decisiones sobre activos individuales.
Los desafíos prácticos de la integración son reales. Los datos de diferentes sistemas suelen utilizar convenciones de nomenclatura, marcas de tiempo o unidades inconsistentes. Contextualizar los datos sin procesar, es decir, adjuntar conocimientos de ingeniería a un número, es lo que separa una alerta útil del ruido.
- Mapee todas las fuentes de datos antes de seleccionar las herramientas de integración. Identifique qué sistemas contienen datos de sensores, historial de órdenes de trabajo y registros de repuestos.
- Estandarice los formatos de datos y las convenciones de nomenclatura en las plataformas de CMMS y EAM antes de conectarlas a las capas de análisis.
- Define qué alertas requieren revisión humana y cuáles pueden generar órdenes de trabajo automatizadas.
- Asigna la propiedad de los datos a roles específicos para que los problemas de calidad se detecten y corrijan rápidamente.
Consejo profesional: La integración efectiva requiere alinear las plataformas de software con los flujos de trabajo de los usuarios. Un panel que muestra 200 métricas simultáneamente crea sobrecarga, no conocimiento. Comience con las cinco métricas que influyen directamente en sus activos de mayor riesgo.
¿Cómo reducen los costos y el tiempo de inactividad el mantenimiento predictivo?
El mantenimiento predictivo es la aplicación más directa del análisis de datos para la fiabilidad de los equipos, y su justificación financiera está bien establecida. Pasar del mantenimiento preventivo al predictivo basado en datos reduce los costes de mantenimiento entre un 25 y un 30 % al enfocar las reparaciones basándose en datos de sensores en tiempo real en lugar de en intervalos fijos. La integración de análisis predictivos explicables puede reduce el tiempo de inactividad no planificado hasta en un 22% y los costes de mantenimiento generales en otro 15%.
La distinción entre las estrategias de mantenimiento importa aquí. El mantenimiento reactivo espera a que ocurra el fallo. El mantenimiento preventivo actúa según un programa fijo, independientemente del estado del activo. El mantenimiento predictivo actúa cuando los datos indican que un activo específico se aproxima a un umbral de fallo. Una bomba programada para un mantenimiento trimestral puede no necesitarlo en el mes tres, pero puede mostrar un desgaste temprano en los rodamientos en el mes dos. El mantenimiento predictivo detecta el segundo escenario; el mantenimiento preventivo no lo hace.
El mantenimiento predictivo basado en la condición convierte el tiempo de inactividad imprevisto en intervenciones planificadas, lo que mejora la eficiencia de la programación en todo el equipo de mantenimiento. El trabajo planificado cuesta menos que las reparaciones de emergencia en piezas, mano de obra y pérdida de producción.
La transición del mantenimiento basado en calendario al mantenimiento basado en datos sigue una secuencia clara:
- Auditar los activos corrientes. Identifique qué activos son críticos para la producción y qué fallas conllevan el costo más alto.
- Instalar supervisión de estado. Instale sensores de vibración, temperatura y acústicos en los activos críticos y conéctelos a una canalización de datos.
- Establecer datos de referencia. Ejecutar sensores durante un período definido para capturar los rangos de operación normales antes de construir modelos de detección de anomalías.
- Construye la detección de anomalías primero. Empieza con modelos que señalen desviaciones de la línea base. Añade la predicción de la vida útil restante (RUL) a medida que se acumulen datos de fallas etiquetados.
- Conectar alertas a órdenes de trabajo. Integra la plataforma de análisis con tu CMMS para que una alerta activada genere una orden de trabajo automáticamente.
- Revisar y perfeccionar. Mide el MTBF y el MTTR mensualmente. Ajusta los umbrales de alerta basándote en las tasas de falsos positivos y los comentarios de ingeniería.
¿Qué mejores prácticas hacen que el mantenimiento basado en datos sea confiable?
El punto de fallo más común en los programas de mantenimiento basados en datos no son los datos. Es la brecha entre lo que arroja un modelo y lo que un ingeniero de confiabilidad confía lo suficiente como para tomar medidas. Los modelos de IA utilizados en el mantenimiento predictivo pueden funcionar como cajas negras, produciendo recomendaciones sin explicar el razonamiento. Los ingenieros que no pueden ver por qué un modelo marcó un activo recurrirán a su propio criterio, lo que anula el propósito del programa.
Las técnicas de inteligencia artificial explicable, como los valores SHAP, abordan esto directamente. Los valores SHAP (SHapley Additive exPlanations) muestran qué entradas de sensores contribuyeron más a la predicción de un modelo. Un ingeniero puede ver que un pico de temperatura en el cojinete y un cambio en la frecuencia de vibración impulsaron conjuntamente una alerta de alto riesgo. Esa transparencia genera confianza en el modelo y acelera su adopción en todo el equipo.
La experiencia en el dominio sigue siendo innegociable. Los ingenieros de fiabilidad deben integrar la física de primeros principios con las salidas de la inteligencia artificial para validar las predicciones. Un modelo que señala un activo como de alto riesgo durante una variación estacional de temperatura conocida puede estar respondiendo a una condición normal de operación, no a una falla. Los ingenieros que entienden la física de sus activos detectan estos falsos positivos antes de que desperdicien recursos de mantenimiento.
El objetivo del mantenimiento basado en datos no es eliminar el mantenimiento preventivo. El mantenimiento basado en datos concentra las horas de trabajo en activos críticos ajustando los planes según el rendimiento real de los equipos en lugar de calendarios fijos. Los activos que los datos muestran que funcionan bien pueden recibir mantenimiento con menos frecuencia. Los activos que muestran signos tempranos de degradación reciben atención más pronto. Este concepto de “mantenimiento adecuado” preserva la estructura de un programa preventivo a la vez que lo hace receptivo a las condiciones reales.
Consejo profesional: Valide los modelos predictivos con el conocimiento de ingeniería al menos trimestralmente. Compare los activos señalados por el modelo con los hallazgos de las inspecciones físicas. Las discrepancias revelan un problema de calidad de los datos o una brecha en los datos de entrenamiento del modelo, los cuales son corregibles.
Los patrones de datos operativos deben analizarse continuamente e integrarse en los planes de mantenimiento para reflejar las condiciones cambiantes de los activos. Un modelo entrenado con los datos del año pasado puede no tener en cuenta los cambios en la carga de producción, las condiciones ambientales o la antigüedad de los activos. El reentrenamiento regular mantiene la precisión de las predicciones.
Principales conclusiones
El mantenimiento basado en datos tiene éxito cuando los datos de sensores de calidad, los sistemas integrados y los análisis explicables se combinan para producir decisiones en las que los ingenieros confían y sobre las que actúan.
| Punto | Detalles |
|---|---|
| Empieza con MTBF y MTTR | Estas dos métricas establecen una línea de base objetiva antes de que se introduzca cualquier modelo predictivo. |
| Prioriza la calidad de los datos | La detección precisa de anomalías y la predicción de la RUL dependen de datos de sensores bien seleccionados, no de la complejidad del modelo. |
| Construir una estructura de datos unificada | La conexión de CMMS, EAM y las fuentes de datos de sensores en un solo ecosistema elimina los silos y aporta información útil. |
| Utilice la inteligencia artificial explicable | Los valores SHAP y técnicas similares muestran a los ingenieros por qué un modelo marcó un activo, lo que fomenta su adopción. |
| Mantén el derecho, no abandones la prevención | Ajustar la frecuencia de mantenimiento en función de los datos de condición de los activos en lugar de reemplazar todas las tareas programadas. |
La sobrecarga de datos es el verdadero enemigo, no la escasez de datos
Trabajando con equipos de mantenimiento en instalaciones industriales, el patrón que veo con más frecuencia no es la falta de datos. Es un exceso de ellos, sin un camino claro desde la lectura de un sensor hasta una decisión de mantenimiento. Las plantas invierten en equipos de monitoreo de condición, los conectan a paneles de control y luego descubren que los ingenieros pasan más tiempo interpretando alertas que actuando sobre ellas.
La solución no es más datos. Es una mejor arquitectura de datos. Un tejido de datos unificado que conecte su CMMS, EAM y fuentes de sensores en una sola vista vale más que cualquier herramienta de análisis individual. La pregunta que los gerentes de mantenimiento deben hacerse no es “¿qué datos tenemos?”, sino “¿qué datos informan directamente una decisión sobre un activo crítico?”
También he visto programas estancarse porque los ingenieros no confían en los resultados del modelo. Ese es un problema que se puede resolver, pero solo si se invierte en la interpretabilidad desde el principio. Mostrarle a un ingeniero las entradas de sensores específicas que provocaron una alerta de alto riesgo es mucho más persuasivo que presentar una puntuación de riesgo sin contexto.
El futuro de la gestión de la confiabilidad se encuentra en la intersección del conocimiento de ingeniería basado en la física y el aprendizaje automático. Ninguno funciona tan bien sin el otro. Los equipos que fomentan esa colaboración desde el principio, en lugar de tratar a la IA como un reemplazo del juicio de ingeniería, obtendrán los mejores resultados de sus inversiones en datos.
— Pedro
Cómo Fullyops apoya la gestión de la confiabilidad basada en datos
Fullyops conecta la gestión de órdenes de trabajo con análisis operativo para proporcionar a los gestores de mantenimiento una línea directa desde los conocimientos basados en sensores hasta las intervenciones programadas. La plataforma integra registros de activos, historiales de órdenes de trabajo y datos de rendimiento en un solo lugar, lo que reduce el esfuerzo manual de correlacionar información entre sistemas. Los gestores de mantenimiento pueden realizar un seguimiento costos de mantenimiento y rendimiento de activos en tiempo real, lo que facilita identificar dónde los ajustes basados en datos tendrán el mayor impacto. Para los equipos que están construyendo o perfeccionando un programa de fiabilidad, el tutorial de asignación de recursos proporciona un marco práctico para alinear la mano de obra y los materiales con los activos que los datos identifican como de máxima prioridad.
PREGUNTAS FRECUENTES
¿Cuál es el papel de los datos en la confiabilidad de los equipos?
Los datos permiten a los equipos de mantenimiento detectar señales tempranas de fallo mediante el monitoreo de sensores y análisis, reemplazando los programas fijos por intervenciones basadas en el estado. Este enfoque reduce el tiempo de inactividad imprevisto y dirige el esfuerzo de reparación allí donde tiene el mayor impacto en el rendimiento de los activos.
¿Qué métricas importan más para el mantenimiento basado en datos?
El tiempo medio entre fallos (MTBF) y el tiempo medio de reparación (MTTR) son las dos métricas fundamentales. Establecen una línea base de rendimiento y revelan si un programa de mantenimiento está mejorando la disponibilidad de los activos con el tiempo.
¿Cuánto puede reducir los costos el mantenimiento predictivo?
La transición al mantenimiento predictivo basado en datos reduce los costes de mantenimiento entre un 25 % y un 30% y puede reducir el tiempo de inactividad no planificado hasta en un 22%, según estudios industriales validados. Estas mejoras dependen de que se disponga de datos de sensores de alta calidad y de un proceso de análisis estructurado.
¿Qué es un tejido de datos unificado en el mantenimiento?
Un tejido de datos unificado conecta sistemas dispares, incluidos CMMS, plataformas EAM y sensores en tiempo real, en un único ecosistema de apoyo a la toma de decisiones. Elimina los silos de datos y ofrece a los gestores de mantenimiento una visión coherente de la salud de los activos en toda una instalación o empresa.
¿Cómo se logra que las predicciones de la inteligencia artificial sean confiables para los ingenieros de confiabilidad?
Las técnicas de IA explicable, como los valores SHAP, muestran qué entradas de los sensores impulsaron la predicción de un modelo, haciendo que el razonamiento sea visible para los ingenieros. La combinación de estos resultados con el conocimiento de ingeniería de primeros principios produce recomendaciones en las que los equipos confían lo suficiente como para actuar.
Recomendado
- Pasos para mejorar la fiabilidad de los activos: guía 2026
- Guía de análisis de rendimiento de equipos para equipos de mantenimiento
- Mantenimiento predictivo: aumenta la fiabilidad y reduce el tiempo de inactividad