El mantenimiento multisitio es la práctica de realizar conservación, reparaciones y gestión de activos en varias ubicaciones bajo un conjunto compartido de normas en lugar de como operaciones aisladas, sitio por sitio. El mejor movimiento inicial es establecer una capa de gobernanza central combinada con un sistema centralizado de órdenes de trabajo, para que cada sitio siga los mismos estándares mientras los equipos locales mantienen la autonomía para actuar con rapidez. Tanto los marcos de certificación como el software especializado existen específicamente para respaldar este modelo.
En resumen:
- La gobernanza centralizada y los sistemas estándar de órdenes de trabajo son esenciales para la escalabilidad, pero los equipos locales deben conservar su autonomía para las operaciones diarias.
- Una taxonomía de datos adecuada, registros de activos compartidos y el seguimiento de inventario integrado previenen errores costosos e inconsistencias en los informes entre sitios.
- Un despliegue gradual, que comience con una prueba piloto en dos o tres sitios, reduce el riesgo y acelera una implementación a gran escala exitosa.
- Roles claros, umbrales de aprobación y la estandarización de contratos de proveedores son fundamentales para evitar retrasos y gestionar los costos eficazmente.
- FullyOps ofrece una plataforma unificada que agiliza las órdenes de trabajo, la gestión de activos y el inventario, facilitando un mantenimiento eficaz en múltiples ubicaciones.
Índice
- ¿Qué es el mantenimiento multisitio y por qué importa?
- ¿Cómo funciona realmente la gobernanza multisitio?
- ¿Qué configuración de tecnología y datos permite las operaciones en múltiples sitios?
- ¿Cuál es la lista de verificación para el despliegue, desde la fase piloto hasta la escala completa?
- ¿Qué desafíos surgen con más frecuencia y cómo los solucionas?
- ¿Qué KPI y paneles de control ofrecen visibilidad a nivel de cartera?
- Lecciones de FullyOps sobre la gestión del mantenimiento de múltiples sitios
- Por qué la gobernanza por fases supera a un despliegue de golpe
- Poner en marcha su programa multisitio con FullyOps
- Fuentes
- PREGUNTAS FRECUENTES
¿Qué es el mantenimiento multisitio y por qué importa?
El mantenimiento multisitio significa una organización, un conjunto de políticas y una estructura de informes aplicada en varias ubicación físicas, ya sean tres almacenes regionales o cuarenta sucursales minoristas. La idea central divide el trabajo en dos capas: lo que se decide una vez en el centro y lo que se ejecuta localmente por las personas que realmente conocen el edificio o la máquina.
Si te equivocas en esa división, terminas con una oficina central microgestionando reparaciones de calderas que nunca ha visto, o con cuarenta centros inventando cada uno su propia versión de un programa de mantenimiento preventivo. Ninguna de las dos opciones funciona a gran escala.
Por lo general, centralizado:
- Política de mantenimiento, procedimientos operativos estándar y protocolos de seguridad
- Contratos de proveedores, acuerdos marco y acuerdos de nivel de servicio (SLA)
- Umbrales de aprobación de presupuestos y decisiones de gastos de capital
- Formatos de presentación de informes, definiciones de KPI y requisitos de auditoría
- Configuración de software, taxonomía de datos y reglas de acceso al sistema
Típicamente local
- Programación del día a día y envío de técnicos
- Evaluaciones de riesgos específicos del sitio y compras menores
- Diagnósticos de primera línea y respuesta de emergencia
- Relaciones con proveedores locales para piezas urgentes de bajo valor
La justificación comercial para hacer esto bien es sencilla. La coherencia reduce la probabilidad de que un fallo reparado de forma económica en un centro se convierta en una avería costosa en otro porque nadie compartió la solución. Las compras centralizadas y los fondos comunes de repuestos compartidos reducen los costes de adquisición mediante el volumen, y la documentación estandarizada hace que las auditorías de cumplimiento sean mucho menos dolorosas.
Ese último punto importa más de lo que la mayoría de los equipos de instalaciones esperan. Los organismos de certificación han formalizado cómo es una “buena” gobernanza multisitio. Guía de certificación multisitio de PEFC describe cómo una función de gestión central puede asumir la responsabilidad de la planificación y la política, mientras que los centros individuales se evalúan en función de ese estándar compartido, en lugar de que cada centro se certifique por separado. SGS aplica una lógica similar en su propio marco de certificación multisitio, el cual explica cómo las funciones centralizadas se evalúan una sola vez y luego se toman muestras de los sitios locales en comparación con esa línea base. Ninguno de los dos marcos fue creado específicamente para el mantenimiento, pero el principio de gobernanza se transfiere directamente: centralizar el pensamiento, estandarizar la pista de auditoría, dejar que los equipos locales ejecuten.
¿Cómo funciona realmente la gobernanza multisitio?
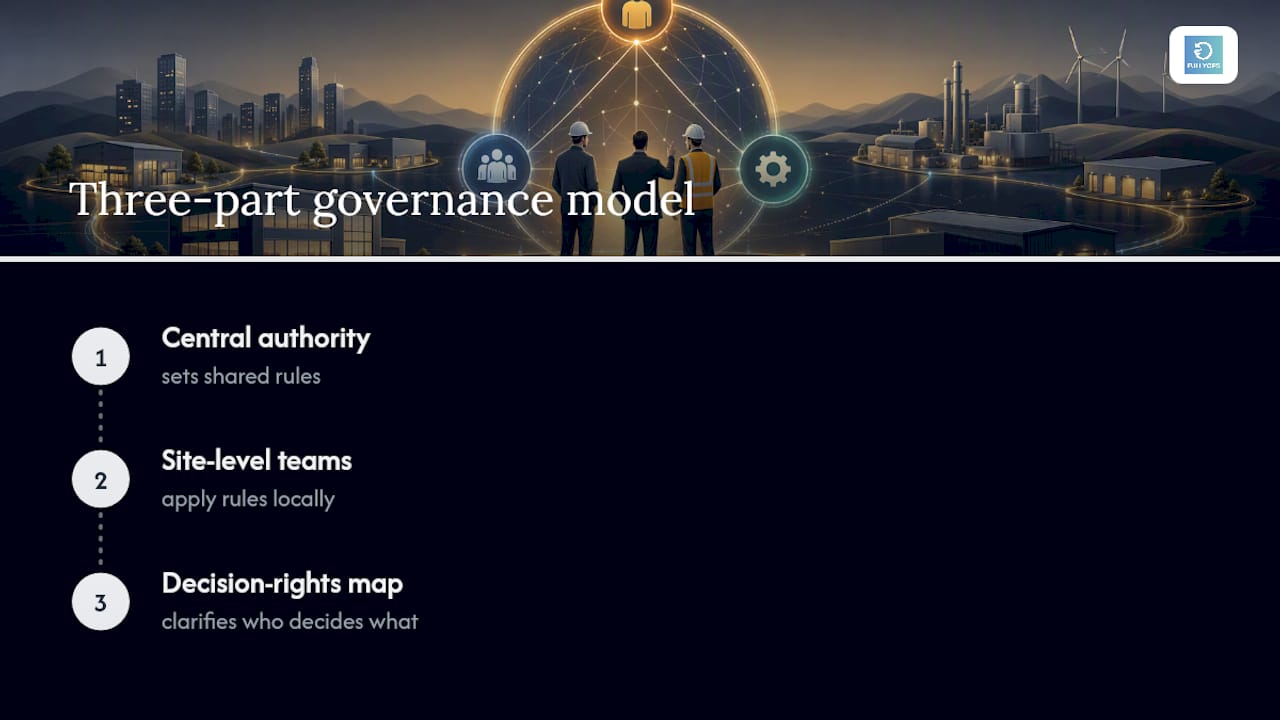
Un modelo de gobernanza viable tiene tres elementos dinámicos: una autoridad central que establece las reglas, una estructura a nivel de sitio que las aplica y un mapa claro de quién decide qué. Si se omite cualquiera de ellos, el modelo vuelve a colapsar en caos o en un cuello de botella.
1. Construir una oficina central de mantenimiento
La mayoría de las organizaciones con cinco o más sedes se benefician de un pequeño equipo central, a veces denominado centro de excelencia, que se encarga de:
- Políticas de mantenimiento y bibliotecas de POE, mantenidas en un lugar con control de versiones
- Contratos de proveedores y suministradores negociados a escala de cartera
- El conjunto de tecnologías: qué CMMS, qué aplicación móvil, qué integraciones
- Informes a nivel de cartera y las definiciones de los KPI sobre las que todos informan
- Directrices presupuestarias, incluidos los umbrales por encima de los cuales los sitios locales necesitan autorización
Este equipo no repara equipos. Establece las condiciones bajo las cuales los equipos locales reparan equipos de manera constante.
2. Definir claramente los roles a nivel de sitio
Cada planta necesita una persona designada que sea responsable de los resultados de mantenimiento, incluso si esa persona también desempeña otras tres funciones. Una matriz de funciones sencilla evita la ambigüedad que arruina los programas de múltiples plantas en el primer año:
| Rol | Posee | Reporta a |
|---|---|---|
| Líder de mantenimiento del sitio | Programación diaria, envío de técnicos locales, compras menores | Gerente de mantenimiento regional o central |
| Coordinador regional | compartir recursos entre sitios, escalamiento, indicadores clave de rendimiento regionales | Oficina central de mantenimiento |
| Gerente de mantenimiento central | Política, contratos de proveedores, configuración del sistema, KPI de cartera | Director de instalaciones o director de operaciones |
3. Decide qué adquiere el estatus de política centralizada
No todo necesita una regla central. Centre la centralización en las cosas que generan riesgo o coste cuando son inconsistentes: procedimientos operativos estándar críticos para la seguridad, especificaciones de repuestos, acuerdos de nivel de servicio de proveedores y los campos de datos que los técnicos deben rellenar en cada orden de trabajo. Deje la flexibilidad en la programación, las compras locales menores y la priorización del día a día en manos de la planta.
4. Establecer la aprobación y la autoridad presupuestaria de antemano
Las disputas sobre el presupuesto son una de las formas más rápidas de paralizar un despliegue en múltiples sitios. Anote, antes del lanzamiento, el umbral de valor por encima del cual un gerente de sitio necesita la aprobación regional o central, y quién puede aprobar gastos de emergencia fuera del horario laboral. La ambigüedad en este punto causa más retrasos que cualquier problema de integración técnica.
¿Qué configuración de tecnología y datos permite las operaciones en múltiples sitios?
La visibilidad centralizada depende totalmente de que cada sitio registre la misma información, en el mismo formato, en relación con el mismo registro de activos. Si te equivocas con el modelo de datos, ningún panel lo arreglará después.
Capacidades principales del sistema a priorizar:
- Un compartido gestión de órdenes de trabajo sistema para que cada solicitud, ya sea originada en Lisboa o en Oporto, siga el mismo flujo de trabajo y los mismos códigos de estado
- Unificado registro de activos con convenciones de nomenclatura coherentes, para que “Chiller 2” en un sitio no signifique algo diferente a “Chiller 2” en otro
- Seguimiento del inventario que muestra los niveles de stock en toda la cartera, no solo por planta, para que las piezas se puedan compartir en lugar de duplicar
- A aplicación móvil los técnicos realmente utilizan en el campo, registrando tiempo, piezas y fotos en el lugar de trabajo en lugar de en un escritorio horas más tarde
- Paneles que consolidan los datos a nivel de sitio en vistas regionales y de cartera sin consolidación manual en hojas de cálculo
Una plataforma como FullyOps aborda esto combinando el control de órdenes de trabajo, el seguimiento del ciclo de vida de los activos y la analítica operativa en un solo sistema, lo cual es de suma importancia en un contexto multisitio porque evita la fragmentación de utilizar hojas de cálculo separadas o herramientas especializadas por ubicación. El orden de trabajo digital se convierte en la única fuente de verdad que vincula una reparación, un técnico, una pieza y un costo, sin importar dónde ocurra.
La integración debe ir más allá del propio sistema de mantenimiento. La integración con el ERP mantiene los datos de costes alineados con los informes de finanzas. La integración con adquisiciones permite a las compras centrales negociar acuerdos por volumen mientras las plantas locales siguen generando sus propios pedidos de bajo valor. Los sensores IoT, cuando las instalaciones justifican la inversión, introducen datos de condición en el mismo registro de activos en lugar de en un silo de monitorización separado.
Ordena la taxonomía antes de escalar. Las categorías de activos, los códigos de fallo y los niveles de prioridad deben significar lo mismo en cada planta, o los informes a nivel de cartera se convierten en un ejercicio para conciliar diez definiciones diferentes de “crítico”. Este es un trabajo tedioso y es la diferencia entre un panel que impulsa decisiones y uno que solo parece impresionante.
Consejo profesional: No intentes implementar el mantenimiento predictivo en toda la planta el primer día. Elige dos o tres tipos de activos con el mayor costo por fallo, consigue un flujo de datos históricos limpios para estos y demuestra el modelo antes de ampliarlo. El mantenimiento predictivo es un problema de datos antes de ser un problema de algoritmos.
¿Cuál es la lista de verificación para el despliegue, desde la fase piloto hasta la escala completa?
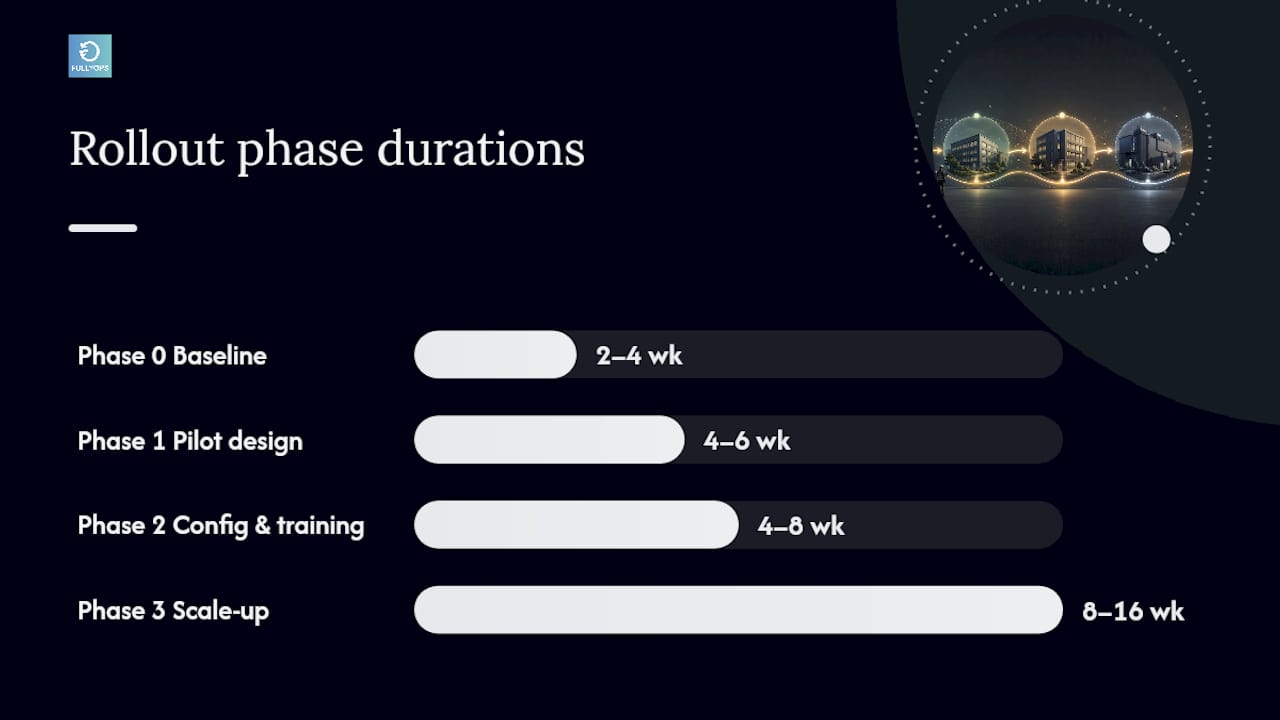
Un programa de mantenimiento multisede realista pasa por cinco fases, y el mayor error que cometen los equipos de instalaciones es omitir la fase piloto para “ahorrar tiempo”. Eso casi siempre cuesta más tiempo después, una vez que los problemas surgen en veinte instalaciones en lugar de dos.
Fase 0: Línea base de la cartera (de 2 a 4 semanas)
- Inventariar cada sitio: recuentos de activos, enfoque de mantenimiento actual, software existente o hojas de cálculo en uso
- Capture baseline KPIs per site, even rough ones: current downtime, average response time, maintenance spend
- Identifica los dos o tres sitios más adecuados para una prueba piloto, idealmente aquellos con clientes potenciales locales comprometidos y perfiles de activos típicos
Fase 1: Diseño del piloto (4 a 6 semanas)
- Redactar los POE principales y el conjunto de políticas que seguirán los sitios piloto
- Acordar las definiciones de los KPI sobre las que todos informarán, antes de que comience el piloto
- Asigne un responsable de mantenimiento del sitio y un coordinador regional para el grupo piloto
Fase 2: Configuración del sistema y entrenamiento (de 4 a 8 semanas)
- Configurar el GMAO o la plataforma de servicio de campo elegida, incluido el registro de activos y las plantillas de órdenes de trabajo
- Configurar integraciones con sistemas de planificación de recursos empresariales (ERP) y de compras cuando proceda
- Capacitar a los técnicos en la aplicación móvil y a los administradores en los paneles de control de informes, idealmente en persona para la primera cohorte
Fase 3: Ampliación (de 2 a 4 meses, según el tamaño de la finca)
- Desplegar sitio por sitio o en oleadas regionales, nunca todo a la vez
- Establecer reservas compartidas de repuestos y renegociar los contratos con los proveedores a la nueva y mayor escala
- Ajustar la matriz de roles a medida que los coordinadores regionales asumen más sitios
Fase 4: Optimización (continua)
- Revisar las tendencias de los KPI trimestralmente y retirar o revisar las políticas que no estén funcionando
- Extender el mantenimiento predictivo a categorías de activos adicionales a medida que la calidad de los datos lo permita
- Reevaluar los SLA de los proveedores anualmente en función del rendimiento real de la cartera
El cronograma total desde la línea de base hasta un despliegue a escala completa suele oscilar entre seis meses y un año para una propiedad de tamaño mediano, y se acerca a los dieciocho meses para carteras más grandes y complejas con activos regulatorios o críticos para la seguridad. El planificación de mantenimiento El trabajo realizado en la Fase 1 es lo que determina si la Fase 2 transcurre sin problemas o se arrastra.
¿Qué desafíos surgen con más frecuencia y cómo los solucionas?
Cada despliegue en múltiples sitios se enfrenta a alguna versión de los mismos cuatro problemas. Ninguno de ellos es inusual, y ninguno es fatal si se planifica para ellos con anticipación.
Las personas y la resistencia al cambio. Los equipos locales que han funcionado a su manera durante años a menudo ven las políticas centrales como interferencia, no como apoyo. La solución táctica es involucrar a los líderes de las instalaciones en la redacción de los POE en lugar de entregar una política terminada; la solución a más largo plazo es mostrarles la mejora de los KPI de su propia instalación una vez que el nuevo sistema esté en funcionamiento.
Duplicidad de logística e inventario. Los sitios sin visibilidad compartida tienden a pedir en exceso los mismos repuestos por precaución, inmovilizando efectivo en toda la propiedad. El seguimiento centralizado de inventario, incluso una simple vista compartida de los niveles de stock, suele reducir esto a los pocos meses de su puesta en marcha.
Calidad de los datos y etiquetado inconsistente. Si diez sitios nombran el mismo activo de diez maneras distintas, ningún informe será jamás fiable. Solucione esto con una taxonomía fija antes del lanzamiento, no después: es mucho más barato aplicar convenciones de nomenclatura desde el primer día que limpiar datos históricos más tarde.
Coordinación de proveedores. Los contratistas que prestan servicios en múltiples sitios dentro de una cartera a veces aplican acuerdos de nivel de servicio (SLA) inconsistentes de una ubicación a otra. Centralizar los contratos de los proveedores, con los mismos tiempos de respuesta y precios estipulados en el acuerdo de cada sitio, elimina esa brecha. Las revisiones académicas de los proyectos de implementación multisitio señalan constantemente gestión del cambio, inconsistencia de datos y coordinación logística como los puntos de fallo recurrentes, lo que coincide con lo que la mayoría de los equipos de instalaciones encuentran en la práctica.
Consejo profesional: Organice una “semana de prueba” antes del lanzamiento definitivo: haga que un técnico experimentado de un sitio piloto en funcionamiento visite el siguiente sitio que se va a incorporar. La mentoría entre pares resuelve más resistencia local que cualquier memorándum de políticas.
¿Qué KPI y paneles de control ofrecen visibilidad a nivel de cartera?
Un panel multisitio solo se gana su lugar si los números que contiene impulsan decisiones reales, y no se limitan a verse ordenados en una presentación mensual. Cinco métricas cubren la mayor parte de lo que un director de instalaciones realmente necesita ver:
- Tiempo medio de reparación, rastreado por sitio y consolidado regionalmente, para detectar qué ubicaciones están teniendo dificultades
- Cumplimiento del mantenimiento preventivo, el porcentaje de tareas de mantenimiento preventivo programadas completadas a tiempo
- Tiempo de inactividad, tanto imprevistos como totales, idealmente vinculados al impacto de costos por sitio
- Costo por sitio, normalizado por recuento de activos o superficie para poder comparar sitios de diferentes tamaños de manera justa
- Utilización de técnicos, lo que muestra si la mano de obra está sobrecargada en algunos sitios y subutilizada en otros
La estructura del panel importa tanto como las métricas en sí. Una disposición útil comienza con una vista consolidada de la cartera, permite que un gerente regional filtre hasta sus propios sitios y permite profundizar en el historial de un solo activo cuando algo necesita investigación. Los equipos a nivel de sitio quieren vistas diarias o semanales de sus propios números; los coordinadores regionales necesitan consolidaciones semanales o mensuales; los ejecutivos típicamente quieren un resumen mensual o trimestral vinculado al gasto y al riesgo.
Donde los informes se conectan con el cumplimiento, vale la pena señalar que normas de la UE sobre información corporativa sobre sostenibilidad están empujando a más organizaciones hacia datos operativos estructurados y auditables, lo que hace que un marco de KPI multisitio claro sea útil mucho más allá del mantenimiento en sí.
Utiliza las tendencias de los KPI para priorizar la inversión, no solo para informar sobre el pasado. Una planta que incumple sistemáticamente los objetivos de cumplimiento del mantenimiento preventivo probablemente necesite una solución de personal o formación antes que equipos nuevos. Una planta con un tiempo medio de reparación (MTTR) alto y una baja utilización de los técnicos probablemente tenga un problema de programación, no un problema de cualificación.
Lecciones de FullyOps sobre la gestión del mantenimiento de múltiples sitios
Los despliegues en múltiples sitios tienden a tener éxito o estancarse debido al mismo puñado de decisiones, y Fullyops ha observado ese patrón repetirse en equipos de instalaciones que pasan de hojas de cálculo y sistemas sitio por sitio a una plataforma compartida.
Las mejoras que mueven consistentemente la aguja rara vez son glamurosas:
- Sustituir el reporte de averías basado en papel o WhatsApp con órdenes de trabajo digitales que registran el tiempo, las piezas y las fotos automáticamente
- Centralizar el inventario para que los fondos de piezas compartidas reduzcan los pedidos duplicados entre sitios
- Estandarizar el registro de activos pronto, antes de añadir más emplazamientos, no después
- Dar a los responsables de las sedes su propia vista de panel para que el compromiso local surja de ver su propio progreso, no de que se les exija cumplir
Los equipos que realizan una prueba piloto en dos o tres sitios antes de escalar tienden a alcanzar informes estables en toda la cartera más rápido que los equipos que intentan incorporar todo a la vez. En cuanto a las compras, involucrar a finanzas y a los líderes de los sitios en la misma conversación desde el principio evita las disputas presupuestarias que de otro modo paralizan los despliegues en la Fase 3. Las negociaciones con proveedores también avanzan más cuando el volumen de toda la cartera, y no solo de un sitio, está sobre la mesa.
Por qué la gobernanza por fases supera a un despliegue de golpe
El consejo convencional sobre el mantenimiento de múltiples sitios se inclina fuertemente hacia la tecnología, como si comprar el software adecuado resolviera por sí solo el problema de la gobernanza. No es así. Las organizaciones que más luchan suelen ser aquellas que configuraron un sistema correctamente pero nunca pusieron por escrito quién tiene permitido aprobar una reparación de 5.000 € sin esperar una semana para su autorización.
Lo que la evidencia realmente respalda es la secuenciación: gobernar primero, luego realizar una prueba piloto, después escalar y finalmente optimizar. Omitir la prueba piloto para cumplir con un plazo de lanzamiento es la razón más común por la cual los programas se estancan alrededor del sitio quince o veinte, una vez que las inconsistencias que una pequeña prueba piloto habría detectado comienzan a multiplicarse en toda la infraestructura.
Si hay algo que priorizar por encima de todo, es la taxonomía de datos. Todo lo que depende de ella, desde los paneles de KPI hasta el mantenimiento predictivo y las negociaciones con proveedores, requiere que cada planta describa el mismo activo de la misma manera. Solucione eso antes de preocuparse por las integraciones o la analítica avanzada.
— Pedro
Poner en marcha su programa multisitio con FullyOps
Fullyops está diseñado exactamente para el problema de gobernanza y visibilidad que esta guía ha abordado: un sistema central para órdenes de trabajo, registros de activos e inventario, con acceso basado en roles para que los líderes de planta, los coordinadores regionales y los gerentes centrales vean cada uno lo que necesitan sin ahogarse en ruido. En lugar de unir hojas de cálculo, hilos de WhatsApp y distintas instancias de CMMS por ubicación, un equipo multisitio obtiene una plataforma que rastrea cada activo, cada técnico y cada pieza en todo el patrimonio.
Una prueba piloto suele comenzar con dos o tres instalaciones configuradas con un registro de activos compartido y plantillas de órdenes de trabajo estándar, lo que proporciona datos de indicadores clave de rendimiento (KPI) limpios de antes y después antes de comprometerse a un despliegue completo. Los planes se estructuran en función del rol para adaptarse al tamaño de la cartera en lugar de obligar a cada técnico a utilizar funciones que no necesita. Visite la plataforma FullyOps para ver los planes actuales y solicitar una demostración configurada en torno a su propia cartera.
Fuentes
Los equipos de instalaciones que formalizan la gobernanza multisitio pueden basarse directamente en marcos de certificación existentes en lugar de redactar políticas desde cero. Guía de certificación multisitio de PEFC establece cómo se evalúan las funciones de planificación centralizada junto con los sitios locales muestreados. El propio documento de certificación multisitio de SGS describe una lógica de evaluación comparable para las funciones centralizadas. Para los sistemas de gestión en general, Referencias de normas ISO vale la pena revisar, y organismos como Preferred by Nature y AENOR ofrece vías de certificación adicionales relevantes para las organizaciones que formalizan controles multisitio.
- Certificación multisitio — PEFC Portugal
- Certificación Multi-Sitio por SGS ICS (PDF)
- Desafíos en la Implementación y Mantenimiento de un Sistema — repositorio institucional
PREGUNTAS FRECUENTES
¿Qué significa realmente “mantenimiento multisitio”?
Significa gestionar la actividad de mantenimiento en varias ubicaciones bajo una estructura de gobernanza compartida, en lugar de que cada sitio ejecute su propio proceso independiente. Por lo general, la política, los contratos de proveedores y los informes se centralizan, mientras que la programación diaria sigue siendo local.
¿Cuánto tiempo dura un despliegue de mantenimiento en múltiples sitios?
Un patrimonio de tamaño medio suele tardar de seis meses a un año desde la evaluación inicial hasta la escala completa, pasando por una prueba piloto antes de un despliegue más amplio. Las carteras más grandes o más reguladas suelen necesitar de doce a dieciocho meses para alcanzar informes estables a escala de toda la cartera.
¿Qué características del software importan más para gestionar múltiples sitios?
Un sistema compartido de órdenes de trabajo, un registro de activos unificado, visibilidad del inventario en todo el portafolio y paneles de control consolidados son lo más importante, ya que son los que convierten los datos dispersos de los sitios en una vista coherente. FullyOps combina estas funciones en una única plataforma diseñada en torno a las órdenes de trabajo, el seguimiento de activos y la analítica operativa.
¿Necesito una certificación formal para dirigir un programa de mantenimiento multisitio?
No, la certificación no es un requisito para operar un modelo de mantenimiento multisitio, pero marcos como la certificación multisitio de PEFC ofrecen una estructura de referencia útil sobre cómo debe funcionar la gobernanza centralizada. Muchas organizaciones utilizan estos marcos como plantilla de diseño incluso sin buscar una certificación formal.
¿Cuál es la mayor razón por la que fracasan las implementaciones de mantenimiento en múltiples sitios?
Omitir la fase piloto y ampliar la política y los sistemas a todos los sitios a la vez es la causa más común de retrasos en las implementaciones. El etiquetado de datos inconsistente y los umbrales de aprobación poco claros tienden a manifestarse solo cuando el conjunto es demasiado grande para solucionarlo rápidamente, razón exacta por la cual un pequeño piloto es importante antes del despliegue a gran escala.
Recomendado
- Top 6 Software de mantenimiento de equipos para equipos de campo 2026
- Las 7 mejores soluciones de gestión de mantenimiento en 2026