En resumen:
- Las estrategias de mantenimiento proactivo como el RCM, el PdM y el PM mejoran la fiabilidad de los equipos y reducen los costes.
- La implementación eficaz requiere la evaluación de la criticidad de los activos, procedimientos estandarizados y el seguimiento de KPI.
- Fomentar una sólida cultura de mantenimiento con el apoyo del liderazgo y la mejora continua impulsa el éxito a largo plazo.
Mejores prácticas de mantenimiento: Mejore la eficiencia y la vida útil de los activos
Las operaciones industriales son cada vez más complejas año tras año, y la presión para reducir el tiempo de inactividad no planificado mientras se controlan los costos nunca ha sido mayor. Sin embargo, muchos jefes de operaciones todavía dependen de hábitos reactivos, solucionando las fallas a medida que ocurren en lugar de construir un programa estructurado y proactivo. La brecha entre las plantas de mejor rendimiento y las instalaciones promedio es mensurable y significativa, y a menudo se reduce a qué estrategias de mantenimiento están implementadas, con qué consistencia se aplican y si las métricas de rendimiento correctas guían la toma de decisiones. Este artículo le ofrece un marco respaldado por evidencias que abarca criterios de selección, metodologías principales, pasos de implementación y herramientas de evaluación comparativa para construir un programa de mantenimiento orientado a resultados.
Índice
- Establecer criterios de selección para las estrategias de mantenimiento
- Metodologías principales de mantenimiento: PM, PdM y RCM explicadas
- Implementación de las mejores prácticas de mantenimiento: Pasos para el éxito operativo
- Evaluación comparativa y mejora continua en la gestión de mantenimiento
- Por qué la verdadera revolución del mantenimiento empieza por la cultura, no solo por la tecnología
- Acelere sus mejoras de mantenimiento con soluciones expertas
- Preguntas más frecuentes
Principales conclusiones
| Punto | Detalles |
|---|---|
| Priorizar los activos críticos | Concentrar los recursos donde las fallas tienen mayor impacto garantiza los mejores resultados de su programa de mantenimiento. |
| Asociar método con activo | Elija enfoques preventivos, predictivos o híbridos según el valor del activo y el riesgo de falla. |
| Rastrear y comparar KPIs | Monitorear la OEE, el MTBF y el cumplimiento permite medir el progreso y detectar brechas frente a los líderes de la industria. |
| Invierte en sistemas digitales | Un CMMS bien implementado y la calidad de los datos son cimientos esenciales para el éxito del mantenimiento a largo plazo. |
| La cultura impulsa los resultados | La capacitación del equipo, el respaldo de los líderes y una mentalidad de mejora son las verdaderas claves para una eficiencia sostenida. |
Establecer criterios de selección para las estrategias de mantenimiento
No todos los activos son iguales y no todas las estrategias de mantenimiento se adaptan a cada situación. Antes de elegir entre el mantenimiento preventivo (MP), el mantenimiento predictivo (PdM) o el mantenimiento centrado en la confiabilidad (RCM), los gerentes de operaciones necesitan un conjunto claro de criterios para guiar esa decisión de manera objetiva. Sin este marco, los equipos se arriesgan a dar un mantenimiento excesivo a los activos de baja criticidad mientras descuidan el equipo cuya falla causaría el mayor daño.
El primer y más importante criterio es criticidad de activos. Pregunte qué sucede cuando este activo falla: ¿detiene una línea de producción entera, crea un peligro para la seguridad o simplemente ralentiza una estación de trabajo? Las respuestas determinan directamente cuántos recursos invertir en el mantenimiento de ese activo. Después de la criticidad, considere estos factores de selección adicionales:
- Valor de los activos y costo de reposiciónEl equipo de alto valor justifica estrategias sofisticadas de seguimiento y prevención.
- Consecuencias del fracasoLos impactos de seguridad, ambientales, normativos y financieros influyen en la selección de la estrategia.
- Requisitos reglamentariosCiertos sectores, como el procesamiento de alimentos y la fabricación farmacéutica, exigen calendarios de inspección específicos y pistas de auditoría.
- Disponibilidad de datosEl PdM requiere una salida de sensores fiable y datos históricos de fallos; sin ellos, el PM puede ser el punto de partida más práctico.
- Preparación de la fuerza laboral y la tecnologíaHasta la estrategia más avanzada fracasa si los técnicos carecen de la formación o las herramientas para ejecutarla.
Según 7 prácticas recomendadas clave para los programas de mantenimiento de fabricación, los equipos líderes priorizan los activos según su criticidad, estandarizan los procedimientos operativos estándar y las listas de comprobación, integran sistemas informatizados de gestión del mantenimiento (CMMS) o plataformas de gestión de activos empresariales (EAM) para la automatización y la programación, capacitan a su personal de manera constante, despliegan estrategias híbridas de mantenimiento preventivo y predictivo, realizan un seguimiento continuo de los indicadores clave de rendimiento (KPI) y fomentan la mejora continua mediante el análisis de causa raíz. Estos siete pilares proporcionan un sólido andamiaje inicial para cualquier proceso de selección.
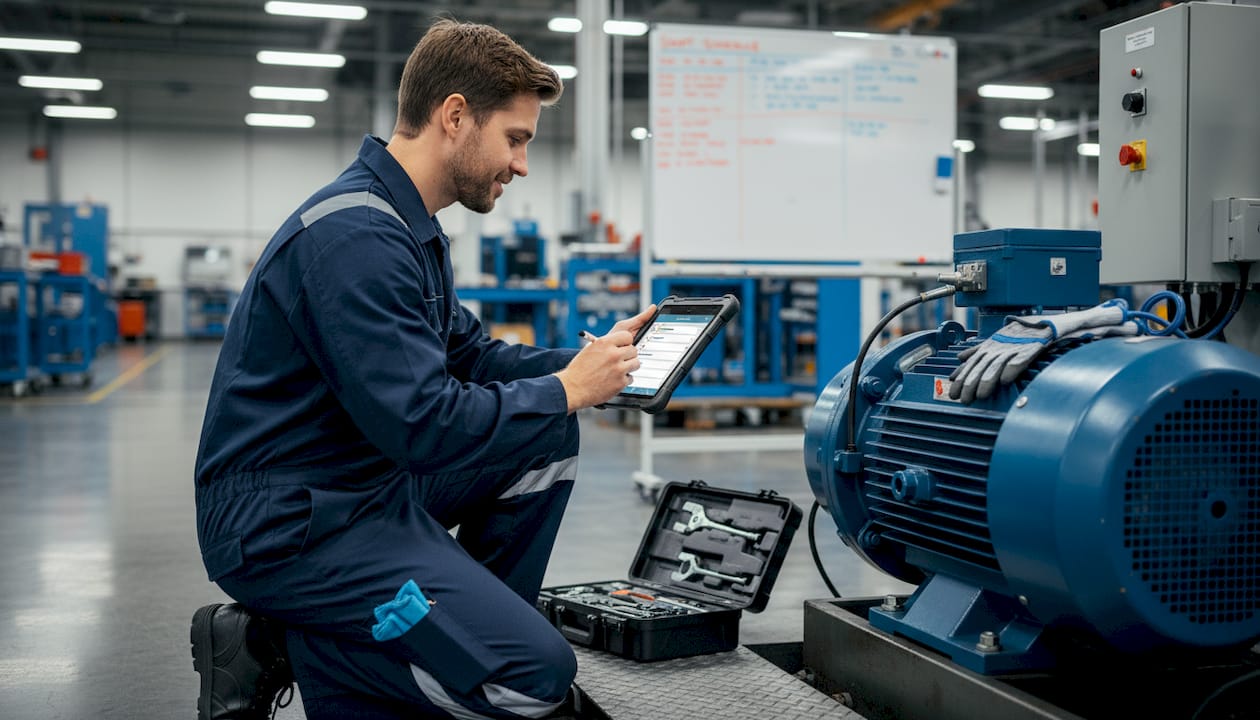
Definir PM, PdM y RCM en esta etapa también es importante. El mantenimiento preventivo (PM) utiliza cronogramas basados en el tiempo o el uso para evitar fallas antes de que ocurran. El mantenimiento predictivo (PdM) utiliza datos de condición en tiempo real para activar el mantenimiento solo cuando se alcanzan umbrales específicos. El mantenimiento centrado en la confiabilidad (RCM) analiza cada modo de falla de manera sistemática para seleccionar la estrategia óptima para esa falla específica. Integrar el conocimiento de estos tres enfoques en sus criterios de selección evita que los equipos recurran por defecto a un solo método cuando una solución estratificada o híbrida serviría mucho mejor.
Consejo profesional: Antes de ampliar su programa de mantenimiento a todos los activos, pruebe el enfoque elegido en los diez activos más críticos de sus instalaciones. Esto limita el riesgo, genera datos reales y genera confianza en el equipo antes de un despliegue más amplio.
Estandarizar las listas de comprobación e integrar herramientas digitales en su flujo de trabajo también da frutos aquí. Un bien estructurado proceso de mantenimiento preventivo reduce la variabilidad, captura el conocimiento institucional y crea la pista de auditoría que los reguladores y los equipos de calidad esperan.
Metodologías principales de mantenimiento: PM, PdM y RCM explicadas
Comprender la mecánica de cada metodología es esencial antes de comprometer recursos. Cada enfoque tiene fortalezas claras, limitaciones genuinas y un rango definido de tipos de activos y contextos operativos donde aporta el mayor valor.
Mantenimiento preventivo (MP) funciona con programas fijos basados en el tiempo transcurrido o en el uso medido en horas, ciclos o kilómetros. Es fácil de planificar, sencillo de asignar y funciona bien para activos con patrones de desgaste predecibles, como cintas transportadoras, filtros y rodamientos lubricados. El riesgo es el mantenimiento excesivo: las tareas realizadas con demasiada frecuencia añaden costes innecesarios y, paradójicamente, pueden introducir fallos al perturbar componentes que estaban operando dentro de los márgenes de tolerancia.
Mantenimiento predictivo (PdM) cambia el momento del mantenimiento a umbrales de condición utilizando sensores que monitorizan la vibración, la temperatura, la calidad del aceite o las firmas eléctricas. Como el trabajo solo se activa cuando las lecturas se acercan a los umbrales de fallo, el mantenimiento predictivo (PdM) evita intervenciones innecesarias y prolonga la vida útil de los activos con mayor precisión. La contrapartida es la inversión inicial en hardware de sensores, infraestructura de datos y capacidad analítica.
Mantenimiento centrado en la fiabilidad es el enfoque más sistemático. En lugar de aplicar una estrategia general, RCM analiza las funciones de cada activo, las formas en que esas funciones pueden fallar y las consecuencias de cada modo de falla. Luego, selecciona la mejor combinación de mantenimiento preventivo, predictivo, monitoreo de condición o funcionamiento hasta el fallo para ese modo de falla específico. Como mejores prácticas para plantas de fabricación en 2026 confirmar, las metodologías clave abarcan MP (basado en tiempo y uso), MPd (basado en condición mediante sensores) y RCM (análisis centrado en la función que selecciona la estrategia óptima por modo de falla).
RCM y PdM no son enfoques que compiten: a menudo son complementarios. RCM define qué estrategia se adapta a cada modo de falla, y PdM proporciona los datos de condición que hacen que esa estrategia sea ejecutable con precisión.
| Metodología | Costo típico | Potencial de ROI | Mejor adecuación de activos | Perfil de riesgo |
|---|---|---|---|---|
| Mantenimiento Preventivo (PM) | De bajo a medio | Moderado | Activos con desgaste predecible | Riesgo de sobremantenimiento |
| Predictivo (Manto. Pred.) | De medio a alto | Alto (hasta 10x) | Bienes de alto valor vigilados | Dependencia de la calidad de los datos |
| RCM | Alto (por adelantado) | Muy alto | Sistemas complejos y críticos | Requiere experiencia analítica |
Un error común es creer que el mantenimiento predictivo (PdM) siempre es superior al preventivo (PM). En realidad, el PdM solo supera al PM cuando hay suficientes datos de sensores de alta calidad y capacidad analítica para actuar en consecuencia. Para activos de baja criticidad y bajo costo con patrones de falla predecibles, el PM es más eficiente. Los enfoques híbridos, donde el PM cubre las tareas rutinarias y el PdM monitorea los parámetros críticos en paralelo, superan sistemáticamente a los programas de un solo método. Consulte el pasos de mantenimiento preventivo que apoyan a la gestión de productos como capa fundamental dentro de una estrategia más amplia.
Implementación de las mejores prácticas de mantenimiento: Pasos para el éxito operativo
Elegir la metodología adecuada significa poco sin una implementación disciplinada y estructurada. Los equipos que se apresuran desde la selección de la estrategia hasta el despliegue completo sin pasos intermedios luchan habitualmente con resultados inconsistentes, baja aceptación por parte de los técnicos y una deficiente calidad de los datos que socava la toma de decisiones futura.
Una secuencia comprobada para integrar las mejores prácticas en las operaciones diarias sigue estos pasos, alineados con Guía de implementación de RCM de la práctica de la ingeniería de confiabilidad:
- Realizar el análisis de criticidad de activosClasifique todos los activos utilizando una matriz de criticidad estructurada que califique el impacto en la seguridad, el impacto en la producción, la frecuencia de fallas y el costo de reparación. Esto prioriza dónde enfocar su programa primero.
- Realizar análisis de fallas funcionales y AMEFPara cada activo crítico, identifique sus funciones requeridas, las formas en que esas funciones pueden fallar y los efectos de cada fallo. El análisis de modos de fallo y efectos (AMFE) cuantifica el riesgo para que la selección de estrategias se base en evidencias y no en la intuición.
- Selecciona la mezcla de mantenimientoAsignar mantenimiento preventivo (PM), mantenimiento predictivo (PdM), monitoreo de condición o funcionamiento hasta la falla (run-to-fail) a cada modo de falla según la criticidad, el patrón de falla y la disponibilidad de datos. Documentar el razonamiento de cada decisión.
- Implementar con órdenes de trabajo estandarizadasTraduzca cada tarea de mantenimiento en una orden de trabajo estandarizada con instrucciones claras, herramientas necesarias, medidas de seguridad y tiempo estimado. Aquí es donde la integración con el CMMS resulta fundamental para la programación y el seguimiento.
- Monitorear los KPIs desde el primer díaEstablecer líneas de base de rendimiento antes de que madure el programa le proporciona el punto de comparación que necesita para demostrar la mejora.
- Depurar mediante análisis de causa raízCuando se producen fallos o los indicadores clave de rendimiento (KPI) disminuyen, trate cada evento como una oportunidad de aprendizaje en lugar de una crisis. El análisis estructurado de causa raíz previene la recurrencia y alimenta la mejora continua.
Los KPI que su equipo sigue definirán lo que puede mejorar. La tabla a continuación muestra métricas clave de mantenimiento junto con los puntos de referencia de los mejores en su clase y el promedio de la industria:
| KPI | Objetivo de mejor desempeño | Promedio de la industria |
|---|---|---|
| Trabajo reactivo (%) | Menos del 10 al 15% | 25 a 35% |
| Cumplimiento del mantenimiento preventivo (%) | Más del 90 al 95% | 60 a 75% |
| Eficiencia general de los equipos | Más del 85% | 60 a 75% |
| Tiempo medio entre fallos (MTBF) | Más de 2.000 a 3.000 horas | 500 a 1.500 horas |
| Tiempo medio de reparación | Menos de 2 a 4 horas | 6 a 12 horas |
| Coste de mantenimiento como % del RAV | Del 2 al 3% | 3 to 5% |
Pro Tip: CMMS data quality is the foundation of KPI reliability. Invest in technician training on accurate data entry before focusing on dashboard sophistication. A beautiful dashboard built on poor data leads to poor decisions.
A frequently underestimated barrier to implementation is cultural resistance. Technicians who have worked reactively for years may view detailed SOPs and digital reporting as administrative burden rather than professional tools. Addressing this requires leadership clarity, visible management support, and early wins that demonstrate the value of the new approach. Use the pasos de mantenimiento preventivo framework as a communication tool to show technicians how structured processes reduce their emergency call-outs and after-hours disruptions.
Evaluación comparativa y mejora continua en la gestión de mantenimiento
A maintenance programme without benchmarking is a programme without direction. Knowing your current performance is only useful when you can compare it against credible external standards and track progress over time. Benchmarking transforms KPIs from internal reporting metrics into strategic decision-making tools.
The metrics that matter most for benchmarking are those that capture both reliability and efficiency. According to maintenance KPI benchmarking data, top-performing plants achieve reactive work below 10 to 15%, PM compliance above 90 to 95%, OEE above 85%, MTBF exceeding 2,000 to 3,000 hours, MTTR below 2 to 4 hours, and maintenance cost at 2 to 3% of replacement asset value (RAV). Average plants, by contrast, see 25 to 35% reactive work, OEE of 60 to 75%, and maintenance costs of 3 to 5% of RAV.
Those gaps represent substantial financial and operational opportunity. A facility spending 5% of RAV on maintenance costs when top performers spend 2 to 3% may be wasting millions annually in avoidable labour, spare parts, and emergency procurement. Closing even a portion of that gap through improved PM compliance and reduced reactive work delivers measurable bottom-line returns.
Target ranges to guide your benchmarking programme include:
- OEE: Aim for above 75% as an intermediate target if you are currently below 65%.
- MTBF: Track trends monthly; a consistently rising MTBF indicates your PM and PdM investments are working.
- MTTR: Reductions here reflect improvements in parts availability, technician skill, and procedure clarity.
- PM compliance: Below 80% signals scheduling, resourcing, or prioritisation problems that need immediate attention.
- Reactive work percentage: Every percentage point reduction here represents a shift from costly emergency response to planned, controlled intervention.
Using industry maintenance benchmarks alongside your internal data gives you an objective external reference point that internal teams cannot dispute. External benchmarking data is particularly persuasive when making the business case for CMMS investment or additional maintenance headcount to senior leadership.
Routine audits and root cause analysis sit at the core of continuous improvement. Schedule quarterly reviews of each KPI, identify the top three drivers of underperformance, and assign corrective actions with clear owners and deadlines. Structured maintenance cost tracking gives you the financial dimension of this analysis, while Herramientas de seguimiento de mantenimiento support the operational data collection that makes KPI reviews credible.
Por qué la verdadera revolución del mantenimiento empieza por la cultura, no solo por la tecnología
There is a persistent belief in industrial maintenance circles that deploying better software, sensors, or analytical tools is the primary driver of performance improvement. The evidence tells a more nuanced story. Technology is an enabler, but it is people and culture that determine whether that technology is used consistently, intelligently, and to its full potential.
Leadership must prioritise training, cross-team collaboration, and continuous improvement to overcome the reactive habits that are deeply embedded in many industrial organisations. Without visible leadership commitment, even the most capable CMMS becomes a data entry burden rather than a decision-support platform.
The highest-performing maintenance teams share characteristics that have little to do with their choice of software. They conduct structured post-failure reviews where technicians are encouraged to contribute without fear of blame. They create mentoring pathways where experienced engineers transfer tacit knowledge to newer team members. They share KPI dashboards openly across shifts and departments, building collective accountability rather than siloing performance data.
Root cause analysis, when genuinely embedded in team culture rather than performed as a compliance exercise, consistently delivers more sustained improvement than any single tool upgrade. SOP adherence, which requires buy-in rather than enforcement, reduces variability in ways that no monitoring system can compensate for. Maintenance tracking technology amplifies these cultural strengths, but it cannot substitute for them. The teams that win long-term are those who invest in both dimensions simultaneously.
Acelere sus mejoras de mantenimiento con soluciones expertas
Ready to put these strategies to work? FullyOps provides operations managers and maintenance teams with the digital tools and structured processes needed to move from reactive maintenance to a proactive, data-driven programme. From a lista de verificación de cumplimiento de mantenimiento that standardises your SOPs and audit trails, to an inventory tracking guide that ensures parts availability never delays a critical repair, and Herramientas de seguimiento de mantenimiento that give your team real-time visibility into work orders and KPIs, FullyOps is built to support every layer of the maintenance best practices framework covered in this article. Explore the platform and take the next step towards measurable operational improvement.
Preguntas más frecuentes
¿Cuál es la diferencia entre el mantenimiento preventivo y el predictivo?
El mantenimiento preventivo utiliza programas basados en el tiempo o en el uso para realizar tareas a intervalos fijos, mientras que el mantenimiento predictivo utiliza datos de sensores basados en condiciones para activar el trabajo solo cuando las lecturas del equipo se acercan a los umbrales de fallo, reduciendo las intervenciones innecesarias.
¿Qué indicadores clave de rendimiento (KPI) deben seguir los equipos de mantenimiento para obtener los mejores resultados?
Haga un seguimiento de la OEE, el MTBF, el MTTR, el porcentaje de trabajo reactivo y el cumplimiento del mantenimiento preventivo como su conjunto principal; las plantas con mejor desempeño logran una OEE superior al 85%, un MTBF superior a 2.000 horas y un trabajo reactivo inferior al 15%, lo que le ofrece objetivos claros hacia los cuales trabajar.
¿Cómo priorizo qué activos mantener?
Utilice un análisis de criticidad de activos que califique cada pieza de equipo según el impacto en la seguridad, el impacto en la producción, la frecuencia de fallas y el costo de reparación; priorizar por criticidad garantiza que sus activos de mayor riesgo reciban la atención más rigurosa primero.
¿Por qué la mayoría de los fallos en las plantas industriales no están relacionados con la edad de los activos?
Research shows that most equipment failures are not age-related, meaning time-based replacement schedules alone are inefficient; risk management strategies that address specific failure modes deliver far better outcomes than focusing on asset age as the primary trigger for intervention.
Recomendado
- Guía de flujos de trabajo de mantenimiento de activos para una eficiencia óptima
- Pasos esenciales de mantenimiento preventivo: maximizar la fiabilidad
- 7 estrategias probadas de gestión de recursos para la eficiencia de los activos